
AgentFoX:LLM Agent-Guided Fusion with eXplainability for AI-Generated Image Detection
AgentFoX: LLM Agent-Guided Fusion with eXplainability for AI-Generated Image Detection
Yangxin Yu1 ,Yue Zhou1 ,Bin Li1* Kaiqing Lin1 ,Haodong Li1,Jiangqun Ni2 ,Bo Cao3† 1广东省智能信息处理重点实验室 2中国中山大学网络安全学院 3中国电子科技集团有限公司智慧城市研究院
摘要
人工智能生成图像(AIGI)日益逼真的特性,催生了对能够可靠区分合成内容与真实影像的取证工具的迫切需求。现有检测系统通常针对特定伪造特征(如频域模式或语义矛盾)进行定制化设计,导致专业性表现差异显著且常出现判断冲突。为解决这些局限性,我们提出AgentFoX框架——这一基于大型语言模型的创新方案,将 AIGI 检测重新定义为动态多阶段分析流程。该方法采用快速集成融合机制,依托由校准专家档案与情境聚类档案构成的精选知识库进行指导。推理过程中,智能体首先进行高层次语义评估,随后通过结构化推理机制,将信号级专家证据转化为细粒度的上下文感知合成结果,最终化解矛盾。AgentFoX不输出粗略的二元判断结果,而是生成详尽的人类可读取证报告以佐证结论,显著提升实际应用中的可解释性与可信度。本研究不仅提供创新检测解决方案,更开创了可扩展的智能体范式,为未来取证工具的智能化集成提供技术支撑。
1.引言
人工智能生成图像(AIGI)凭借其逼真的表现力引发广泛关注,但同时也带来了复杂虚假信息和超写实伪造品等重大社会挑战。针对这一问题,学术界开发了种类繁多且快速发展的专业 AIGI 检测算法,这些算法专门针对不同类型的生成式伪影进行识别。例如,部分方法通过分析扩散模型的重建残差(如 DRCT [2]),另一些则运用频域分析技术提取潜在的上采样特征指纹(如SPAI[13]),而 RINE [15]和Patch Shuffle[45]等技术则分别聚焦于视觉概念不一致性与非语义模式的分离。由于这些模型学习的是截然不同的伪造特征特征,其检测效果本质上具有情境依赖性——擅长分析某一类图像的检测器,在处理另一类图像时可能效果欠佳。
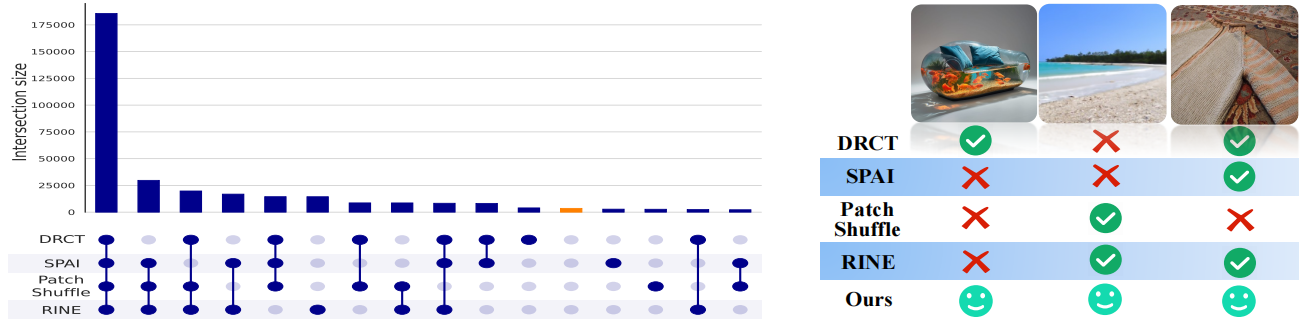
图1. AIGI 检测器间的共识与分歧分布。样本来自七个公开数据集(第4.1节)。 (左)UpSet图定量分析了四种专家检测器的性能表现。 (右)可视化案例展示了这些具有挑战性的分歧案例。 不同专家在不同图像上表现各异,导致信号冲突。
我们在图1中通过实证研究展示了不同方法的专业化特征,该图直观呈现了多位信号级专家检测器[2,13,15,45]对正确检测结果达成的共识。分析结果显示显著的共识差异:虽然55.83%的样本被所有专家正确识别,但仅有1.07%的样本存在全盘误判。数据集的绝大部分样本(43.1%)处于高度碎片化的分歧区域,仅特定子集检测器能成功识别。这种碎片化特征强烈表明,每个检测器都具备独特的“专长”,而能够智能融合其输出结果的系统将实现更强的鲁棒性和泛化能力。然而传统集成方法如元分类器面临关键部署障碍,因其依赖昂贵且数据密集型的再训练过程,导致架构僵化难以轻松整合最新最先进的检测器(SoTA)。 当前,针对多检测器集成的研究成果仍较为匮乏,而多数投票等基础策略既无法解释检测结果分歧,也难以适应图像特定语义与上下文特征。为填补这一空白,我们提出AgentFoX——首个基于智能体驱动的多专家融合框架,专为 AIGI 检测中的动态多阶段推理设计。AgentFoX采用两种预计算知识资源:用于评估检测器可靠性的专家档案,以及编码生成图像中上下文模式的聚类档案。这些先验知识支持无需重新训练即可实现零样本取证推理,并能快速集成新检测器。在这些档案的引导下,大语言模型智能体通过规则推理融合异构线索并解决冲突。其规则遵循人类取证专家经验提炼的指导原则,约束决策过程避免推测性输出,确保结果具有透明度与证据支撑性。
综上所述,本文的主要贡献如下:
- 我们提出AgentFoX——首个基于智能体引导的多专家融合框架,用于 AIGI 检测。该框架通过预计算的专家特征(模型指标)和聚类特征(数据指标)进行引导,实现异构检测器的融合,无需重新训练即可完成零样本取证推理,并能快速适应新检测器。
- 我们通过可追溯推理范式实现了多专家 AIGI 检测的可解释性。智能体生成的透明取证报告通过记录证据、专家共识及冲突解决依据来论证结论,用完全可审计且可解释的工作流程替代了晦涩的聚合过程。
- 在高冲突 AIGI 和真实场景基准测试中,我们实现了卓越的准确率与鲁棒性,持续超越单一检测器及传统集成模型的表现。
2.相关研究
信号级专家模型在 AIGI 检测中的应用 早期 AIGI 检测器通常采用CNN架构(如CNNSpot[35]),这些模型基于ProGAN训练并展现出显著的跨GAN泛化能力。后续研究如UnivFD[42]和 RINE [15]通过微调基于CLIP的视觉编码器提升了泛化性能,充分证明了利用基础模型的优势。后续方法如C2P-CLIP[34]、RepDFD[20]和Effort[39]采用参数高效微调(PEFT)技术以保留预训练知识。除编码器调优外,研究还探索了数据增强与偏差缓解技术: OMAT [47]引入对抗性生成的语义偏差样本, DDA [3]和B-Free[8]则采用重建图像对。辅助线索也被有效利用——例如DIRE和 DRCT 研究重建差异性,FatFormer[22]采用频域表征。尽管取得这些进展,许多信号级方法仍依赖特定低级伪影特征,这本质上限制了其对未知伪造类型抗干扰能力。
基于 MLLM 的 AIGI 检测技术 近年来多模态大语言模型(MLLMs)的进展推动了其在AI生成图像(AIGI)检测中的应用。早期尝试要么在指令遵循数据集上对MLLMs进行微调[36,44],要么引入基于规则的强化学习协议[12,37]。尽管这两种策略有助于使模型适应任务需求,但受限于当前 MLLM 视觉编码器的感知能力不足,其准确率往往难以突破瓶颈[21]。 为解决这些局限性,部分研究将多语言模型(MLLMs)与外部法医专家相结合,将专家输出结果或特征图输入语言模型[4,48]。这种耦合方式虽能提升准确率,但通常需要复杂的对齐步骤和资源密集型 VQA 式标注,导致系统扩展性受限,且联合系统鲜少能超越单个专家的最佳表现。例如AIGIHolmes[48]采用视觉专家与 MLLM 之间的固定融合方案,其设计采用静态架构且未采用任何智能体驱动决策机制。
基于智能体的方法虽出现时间较晚,但其功能定位存在显著差异。以UniShield[11]为例,该系统部署感知智能体将每张图像定向至特定检测路径——其核心功能是任务选择器而非图像融合引擎,且不整合来自多个取证源的冲突性预测结果。类似地,Agent4FaceForgery[17]通过多智能体交互机制合成多样化深度伪造训练数据,但这些智能体完全采用离线运行模式,且不参与实时推理过程。 据我们所知,目前尚无研究能将基于大语言模型(LLM)的智能体配置为在推理过程中自适应融合多种模态特异性 AIGI 检测器——该过程需依托专家画像特征指导,并具备内置可解释性。当不同领域专家采集的法医证据虽具有互补性但可能存在矛盾时,这种能力至关重要,需要通过动态、内容感知的解析机制来确保决策的一致性和可靠性。我们的框架通过使LLM智能体能够对视觉-语言大语言模型(VLLM)与专业 AIGI 检测器的输出进行推理,并根据具体案例进行整合,有效填补了这一技术空白。这种基于上下文的融合机制显著提升了对未知生成器的泛化能力,其性能表现优于任何单一模型的独立应用。
3.方法
我们提出的AgentFoX AIGI 检测框架包含两个解耦组件:特征分析(第3.1节)和智能推理(第3.2节),如图2所示。
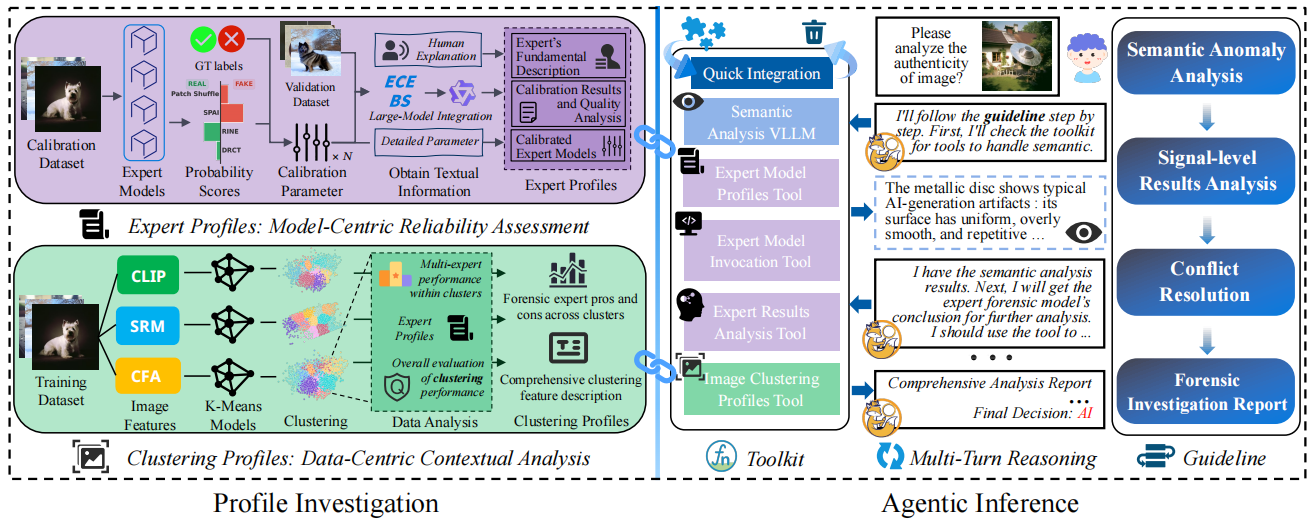
图2. AgentFoX框架概述。左图:特征分析模块构建专家特征与聚类特征;右图:智能推理模块通过工具包整合这些特征,执行多阶段取证推理并生成真实性报告。
该设计通过一次性特征分析步骤实现新检测器的快速集成,无需重新训练核心智能体或其他现有专家模型。基于大语言模型的智能体随后利用这些经过校准且具备上下文感知能力的特征分析结果,将异构法证证据整合为连贯且基于证据的决策。 在特征分析阶段,我们构建了两个互补性特征模型:专家特征模型用于量化各检测器的校准可靠性,聚类特征模型则用于捕捉其在语义图像聚类中的上下文相关性能表现。在智能推理阶段,智能体遵循基于指导原则的ReAct式[41]循环机制运行。该机制通过调用工具从语义专家和信号级专家处收集证据,审核专家输出结果,并基于特征模型进行上下文感知的权重调整以解决冲突。整个过程最终生成多维度且可解读的法证报告。
3.1. 特征分析
该离线阶段通过构建知识库为智能体提供数据驱动的先验信息。我们分析各专家检测器的性能表现及数据统计特性,将这些信息提炼为两组可解释的LLM模型配置文件:专家特征文件与聚类特征文件。具体数据划分方法详见第4.1节。
专家配置文件:模型驱动的可靠性评估 多个异构信号级专家会对图像是否由人工智能生成生成置信度评分,为智能体决策提供依据。然而,来自大型 AIGI 基准测试[18]的经验校准曲线显示存在系统性校准偏差——原始概率估计值往往相对于真实后验分布存在过度自信现象。为确保专家间公平比较并为代理框架提供可信的决策指标,我们实施概率校准,将原始分数转化为可跨模型比较的可解释信号。 设M={M1 ,... ,MN}为N个预训练 AIGI 检测器组成的面板。对于每个专家Mj和图像Ii∈Dtrain,我们获取原始预测分数pij=Mj(Ii)。这些分数采用五种广泛采用的事后、模型无关校准方法进行校准——温度缩放[9]、普拉特缩放[30]、等张回归[25]、直方图分箱[43]和Beta校准[16],其中方法m与专家Mj的映射关系记为Fj(m)。