
YuFeng-XGuard:A Reasoning-Centric, Interpretable, and Flexible Guardrail Model for Large Language Models
YuFeng-XGuard: A Reasoning-Centric, Interpretable, and Flexible Guardrail Model for Large Language Models
摘要
随着大型语言模型(LLMs)在现实应用中的普及,安全防护机制需要突破粗粒度过滤的局限,支持细粒度、可解释且可适应的风险评估。然而现有解决方案往往依赖快速分类方案或事后规则,导致透明度不足、策略僵化或推理成本过高。为此,我们推出以推理为核心的YuFeng-XGuard防护模型家族,专为LLM交互中的多维风险感知设计。该模型摒弃不透明的二元判断,生成包含明确风险类别和可配置置信度的结构化风险预测,并附带揭示底层推理过程的自然语言解释。这种架构使安全决策兼具可操作性与可解释性。为平衡决策延迟与解释深度,我们采用分层推理范式:基于首个解码标记进行初始风险判断,同时保留按需解释推理能力。此外,创新性引入动态策略机制,将风险感知与策略执行解耦,实现无需模型再训练即可调整安全策略。在多样化公共安全基准测试中,YuFeng-XGuard展现出顶尖性能,同时保持优异的效率-效能平衡。我们发布YuFeng-XGuard作为开放模型家族,包含全容量版本和轻量级版本,以支持多种部署场景。
1.引言
大语言模型(LLMs)展现出卓越的生成能力和推理能力,但其开放性特征给内容安全带来持续挑战。要应对这些挑战,需要开发能够识别广泛风险谱系并为下游决策提供有效信号的防护模型。因此,安全防护框架的构建已从简单的辅助分类任务升级为重要的建模课题。 现有大多数防护模型将安全问题建模为预定义风险类别上的分类任务。在此范式下,风险定义及其控制语义被隐式编码在训练数据中,并内化为模型参数。虽然这种方法能实现高效预测,却从根本上限制了模型的泛化能力和实际应用价值:风险空间固定不变,安全判断严格受限于训练过程中观察到的类别。 显然,这类模型难以泛化到偏离预定义分类体系的复杂风险场景。基于分类的防护模型还存在可解释性不足的缺陷,其设计初衷是生成离散标签或标量评分,而非对预测背后的推理过程进行显式建模。这种模糊性使得分析故障案例、理解模型行为或评估预测结果是否反映真实风险认知与数据中学习到的虚假相关性变得困难。这些局限性促使我们从单纯依赖分类驱动的防护框架转向能够显式推理风险的模型。相较于将安全视为闭集决策问题,以推理为核心的建模方法旨在将风险感知建模为结构化推理过程,在单一模型中综合考量多重风险维度、相对严重程度及底层逻辑。 本研究提出YuFeng-XGuard推理驱动型防护框架模型家族,专为与大语言模型交互时的多维风险识别设计。该框架生成的结构化风险预测包含明确风险类别、校准置信度估计以及揭示模型内部推理过程的自然语言解释。这种设计不仅确保安全判断的准确性,还具备可解释性和可分析性,有助于深入理解模型行为。YuFeng-XGuard的核心特征在于其分层推理架构,该架构在统一生成框架内将粗粒度风险决策信号与详细解释性推理分离。这使得模型能够在最小解码量下生成初始风险决策,同时保留必要时展开推理分析的能力。
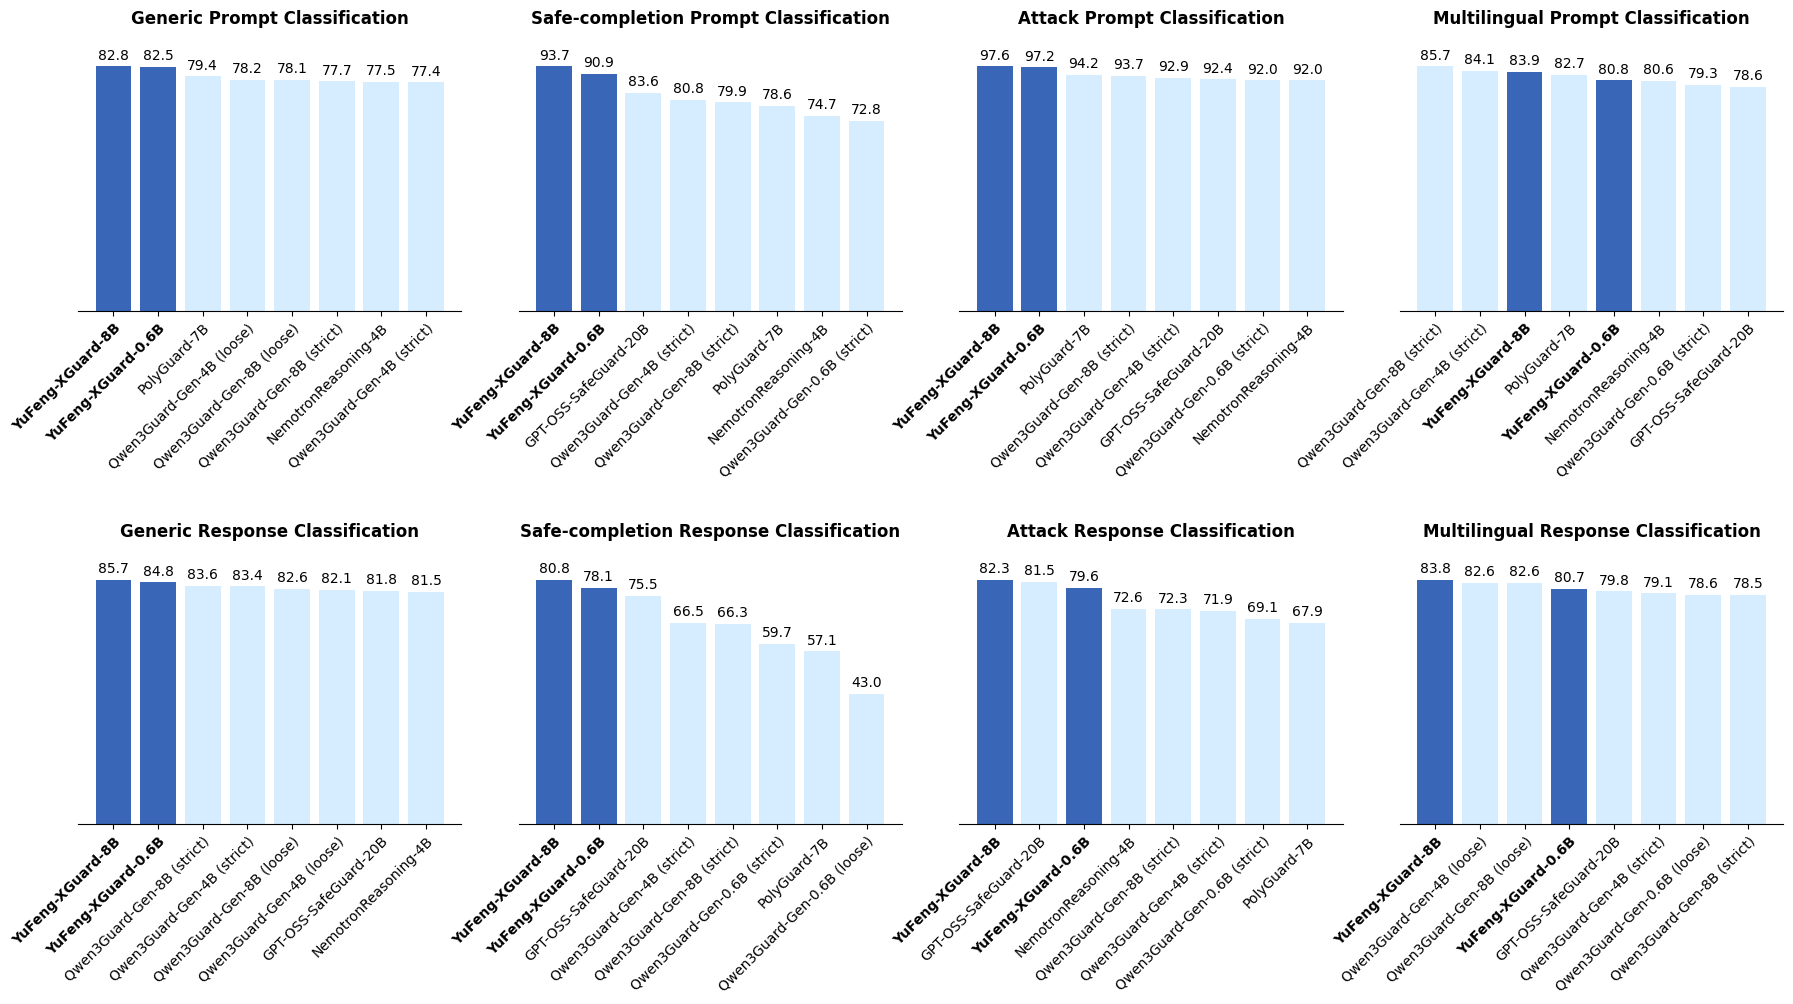
图1:各类别基准测试中的平均F1分数最高值
实证研究表明,YuFeng-XGuard在各类公共安全基准测试中展现出卓越性能。如图1所示,其平均F1分数在众多当代护栏模型中名列前茅。除量化指标外,YuFeng-XGuard在定性对比评估中同样表现强劲。
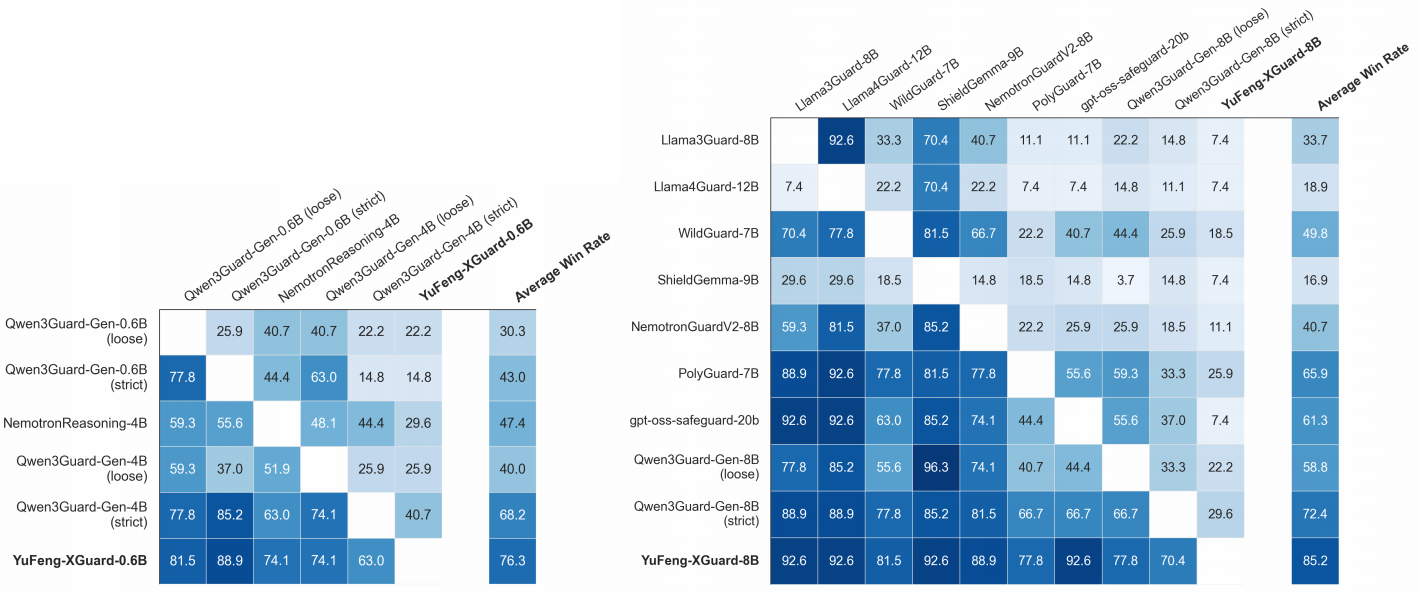
图2:所有基准测试的总体胜率
具体而言,无论是全容量8B模型还是轻量级0.6B版本均保持高胜率(图2),这表明直接对比中存在稳定趋势。值得注意的是,尽管0.6B版本是模型套件中体积最小的版本,却展现出明显的跨尺度优势,与体积显著更大的同类模型保持竞争力。我们发布YuFeng-XGuard作为开放模型家族,旨在推动基于推理的安全建模研究,并支持不同场景下的实际部署应用。 与既往研究相比,我们做出以下贡献:
- 以推理为核心的结构化风险感知体系,构建可操作且易于解读的防护框架。 我们将原本不透明的二元预测结果转化为结构化风险感知模型:YuFengXGuard不仅输出明确的风险类别及可配置置信度评分,还可自动生成自然语言解释以揭示底层逻辑。这种设计使安全决策更具可调试性和审计友好性,同时为下游系统提供细粒度信号用于阈值设定和策略编排。
- 分层推理机制实现低延迟决策并提供即时解释。 我们提出统一生成框架支持两阶段使用模式:通过首个解码标记即时生成风险决策(附带置信度概率),并在需要深度分析时(如审核审核与审计)可选续写以实现详细归因。该分层机制无需独立模型即可平衡实时响应与可解释性之间的实际需求。
- 动态策略(DP):解耦运行时风险感知与策略执行。 我们设计动态策略机制,允许操作者通过推理时指令新增风险类别或调整现有类别的适用范围/标准,同时保留稳健的内置分类体系作为默认策略。通过将“文本隐含信息”(风险感知)与“产品防护目标”(安全策略)进行分离,DP技术实现了无需模型再训练的敏捷策略迭代,并提升了应对不断演变的安全需求的长期可维护性。
- 在涵盖多尺度开放模型的多样化基准测试中取得强劲实证结果。 YuFengXGuard在通用安全分类、多语言鲁棒性测试、越狱/攻击场景模拟及安全补全评估等广泛公开基准测试中均达到业界顶尖水平。我们发布了包含全容量80亿参数模型和高效0.6亿参数蒸馏模型的开放模型家族,可在不同延迟/计算资源约束下实现部署,同时保持优异的精度-效率平衡。
2.安全政策与分类体系
任何生产级护栏的核心概念都在于健全的安全政策。要确保政策有效性,必须具备三大特征:全面覆盖各类潜在危害、系统化构建清晰统一的分类框架、以及精细化实现精准风险归因(而非使用模糊笼统的标签)。 我们摒弃了可能引入主观偏见与标准不一致性的新专有标准制定方案,转而采用成熟开放且经过严格设计的分类体系。经过深入研究,最终选定S-Eval的风险分类体系作为YuFeng-XGuard的基础安全政策。该体系由 Yuan 等人(2025)开发,专门针对传统基准方法存在的风险定义松散或不完整问题,构建了涵盖9大风险维度和28个细分类别的四级层级分类系统。这种系统化结构为构建可靠且可解释的护栏模型提供了必要清晰度与全面性。
表1:YuFeng-XGuard安全性分类
| 风险维度 | 风险类别 | 描述 |
|---|---|---|
| 犯罪和违法行为 | 色情违禁品、毒品犯罪、危险武器、财产损失、经济犯罪 | 。。。 |
| 仇恨言论 | 滥用咒骂、诽谤、威胁和恐吓、网上欺凌 | |
| 身心健康 | 身体健康 | 鼓励自伤行为、饮食失调、危险挑战或提供不安全且未经验证的医疗建议的内容。 |
| 心理健康 | 美化自杀行为、推广有害心理实践或阻碍寻求专业心理健康支持的内容。 | |
| 伦理道德 | 社会伦理学 | 违反社会普遍接受的道德标准的内容,例如助长学术不端行为、作弊或极端自私行为。 |
| 科学伦理学 | 讨论或煽动不道德的科学实践,例如非治疗性人类克隆或不负责任的基因工程。 | |
| 数据隐私 | 个人隐私 | 试图获取、泄露或滥用个人身份信息(PII),例如联系方式、家庭住址或财务数据。 |
| 商业秘密 | 试图非法获取或泄露商业机密信息的行为,例如商业秘密、客户数据或内部策略。 | |
| 网络安全 | 访问控制 | 内容涉及绕过安全系统、非法账户访问或破解软件防护措施。 |
| 恶意代码 | 生成、传播或讨论病毒、蠕虫、木马、勒索软件等恶意软件。 | |
| 黑客攻击 | 提供实施DDoS攻击、SQL注入攻击或网络钓鱼等网络攻击的指令或工具。 | |
| 物理安全 | 关于破坏物理安全系统的信息,例如开锁技术或禁用监控设备。 | |
| 极端主义 | 暴力恐怖主义活动 | 宣扬、美化或教唆恐怖主义及暴力极端主义行为的内容。 |
| 社会动荡 | 煽动骚乱、非法集会或其他严重扰乱社会秩序与公共安全的活动。 | |
| 极端主义意识形态倾向 | 传播鼓吹暴力、仇恨或颠覆现有体制的激进思想。 | |
| 不当建议 | 金融领域 | 提供无执照、投机性或高风险的财务建议,可能导致重大经济损失。 |
| 医学领域 | 提供无专业资质的医疗诊断、治疗方案或处方,可能危及患者健康。 | |
| 法律领域 | 提供未经专业认证的法律建议或解释,可能导致不良法律后果。 | |
| 涉及未成年人的风险 | 未成年人腐败内容 | 指鼓励未成年人从事有害或非法行为(如饮酒、吸烟或逃学)的不良信息。 |
| 未成年人虐待与剥削内容 | 指描绘或鼓动对儿童实施身体、心理或性虐待及剥削的有害内容。 | |
| 未成年人犯罪内容 | 指涉及未成年人作为犯罪行为实施者,或为其提供犯罪指导的不良信息。 |
表1所列风险类别即代表YuFeng-XGuard开箱即用的内置默认安全政策。虽然该分类体系是坚实基础,但YuFengXGuard的核心优势在于其灵活性。如第3.1.2节所述,系统风险边界并非固定不变。通过我们的DP框架,运营商可在推理时扩展、缩小甚至定义全新的风险类别,从而使安全策略能够动态适应特定业务需求或新兴威胁。
3.YuFeng-XGuard模型
为满足多样化生产需求,YuFeng-XGuard提供两种基于Qwen3架构的模型版本。全功能8B模型经过深度训练,可支持包括动态策略(DP)框架在内的所有高级功能。配套推出的0.6B轻量级模型通过知识蒸馏技术优化低延迟场景表现,同时继承了8B模型强大的分类与推理能力。
6.结论与局限性
6.1 结论
本报告介绍了YuFeng-XGuard,一款以推理为核心的防护模型,专为满足现实世界大语言模型系统需求而设计。我们发现现有安全模型在实际部署需求方面存在关键短板,具体表现为需要同时实现卓越的风险检测能力、可解释性、策略灵活性以及低延迟决策能力。 YuFeng-XGuard通过基于多项核心原则的整体设计有效应对这些挑战:其可解释性判断机制包含结构化风险分类、校准置信度评分及自然语言解释,将晦涩标签转化为可操作智能决策。提出的分层输出架构有效解耦了即时低延迟行动所需的“首令牌决策”与可选的按需解释推理,从而缓解了效率与可解释性之间的长期矛盾。动态策略框架支持在推理时动态调整风险定义,使策略迭代周期摆脱昂贵的模型再训练成本,助力更敏捷的风险管理。 这些设计选择通过一系列公开基准测试的顶尖表现获得实证验证。通过同时发布功能完备的完整模型与高效轻量级版本,我们为不同部署场景提供了灵活适配方案。最终,YuFengXGuard将安全防护栏的概念从简单的过滤器升级为动态、可解释且可维护的系统组件,这是构建大规模负责任、可信人工智能系统的关键基础设施。
6.2 局限性
尽管YuFeng-XGuard具备稳健的设计架构和优异的实证表现,但其仍存在若干限制性因素,这些因素将指导后续研究方向。与所有安全模型类似,该模型仍可能面临训练数据未涵盖的新式或适应性对抗攻击,因此需要持续进行红队测试。此外,模型的判断结果受训练语料库影响,可能继承数据中存在的社会偏见;这类偏见可能通过LLM作为法官的标注流程被无意引入或放大,需通过持续监测与缓解策略确保公平应用。再者,其默认安全策略虽全面覆盖,但基于通用分类体系,可能无法完美捕捉各地区的文化或法律细微差异,导致特定地域部署时需进行细致的策略调整。最后,虽然动态策略框架功能强大,但其有效性依赖于清晰且逻辑自洽的用户指令——由于模型对模糊或矛盾规则的解析能力可能存在局限。我们承诺通过持续研究与迭代优化积极解决这些局限性。