
editprint
Editprint: General Digital Image Forensics via Editing Fingerprint with Self-Augmentation Training
Haiwei Wu1 ,Kemou Li2 ,Yuanman Li3,Jiantao Zhou2B
摘要
数字图像取证技术能够确保相机源识别(CSI,camera source identification)、合成图像检测(SID,synthetic image detection)及社交网络来源追溯(SNP,social network provenance)等任务中的信息可信度。这些任务通常依赖于相机内部操作、拍摄后编辑或合成生成过程中留下的图像处理历史痕迹。然而,现有的大多数取证方法存在明显局限性:
1)往往仅关注特定相机的特征痕迹(如广为人知的 PRNU 特征); 2)需要大量标注训练数据。
为解决这些问题,我们提出Editprint这一新型通用取证特征,它能以极少的未标注训练数据捕获高度多样化的相机内与相机外处理历史痕迹。理想情况下,任何经历相同拍摄、编辑和传输流程的图像都将产生完全一致的Editprint特征,反之亦然。为建模相机内与相机外操作过程,我们基于自增强策略设计了在线编辑数据池。该数据池仅需少量训练数据(例如10条样本),即可模拟由相机内处理及后续相机外操作产生的海量编辑链路(例如10⁷条)。为确保Editprint在不同编辑链路中具备优异的区分能力,我们建议使用这些编辑链路的文字描述作为标签,并通过语言引导对比学习对Editprint特征进行监督训练。大量实验表明,Editprint在现有自监督取证方法中表现更优,尤其在SNP和SID等非相机应用场景中。我们希望Editprint能激励取证领域,并成为自监督取证领域的新型基准方法。
源代码可在以下地址获取:https://github.com/HighwayWu/Editprint
1.引言
在数字化时代,随着图像编辑工具的广泛应用,人们对图像的真实性和可信度产生了诸多质疑。随着生成对抗网络(GANs)[27]和扩散模型(DMs)[32]等图像生成技术的飞速发展,这些质疑愈发凸显——这类技术导致合成图像大量涌现并广泛传播。在此背景下,作为保障多媒体内容可信度的关键技术,数字图像取证领域受到越来越多的关注。该技术可应用于多种场景以验证图像的真实性与原创性,包括SID[62,92]、SNP[49,52,95,96]以及CSI[39,56,90]等方法。 与为特定任务设计专用取证算法不同,近年来众多研究尝试通过自监督学习[21,28,58,99]开发通用型取证方法。由于无需依赖特定任务的训练数据,自监督取证技术能够学习更广泛的取证特征,从而具备更强的通用性,适用于各类取证场景。早期的研究主要聚焦于与相机相关的特征,例如广为人知的 PRNU [54]——该方法旨在表征相机传感器硅材料中固有的非均匀性特征。近年来,基于深度学习的方法[21,28,58,87,91,99]通过大量标注数据探索了更通用的取证特征。这类通用取证方法的一个共同特点在于采用自监督对比训练方式,旨在仅从同一台相机拍摄的图像中提取相似特征。然而,这些方法存在两大主要局限:应用范围受限于相机设备以及对数据量要求过高。具体而言,其适用性本质上仅限于与相机相关的任务(如CSI),而不适用于对相机依赖度较低的取证任务(如SID和SNP)。此外,这些方法需要大量标注训练数据,而数据收集不仅成本高昂,且难以满足未来相机型号的需求。 为解决这些局限性,我们在本研究中提出了一种名为“Editprint”的新型取证特征方法,其核心设计包含三个关键要素(如图1所示): a) 利用原始图像和图像信号处理器(ISP),我们可在线模拟大量相机内部处理轨迹,从而无需依赖海量标注数据; b) 设计了编辑池机制,能够高效地对多种相机外部处理流程进行在线采样,仅需少量原始数据即可生成丰富的外部处理轨迹; c) 提出创新的自增强训练(SAT)方法,可从这些模拟的相机内外部处理轨迹中高效提取Editprint特征。
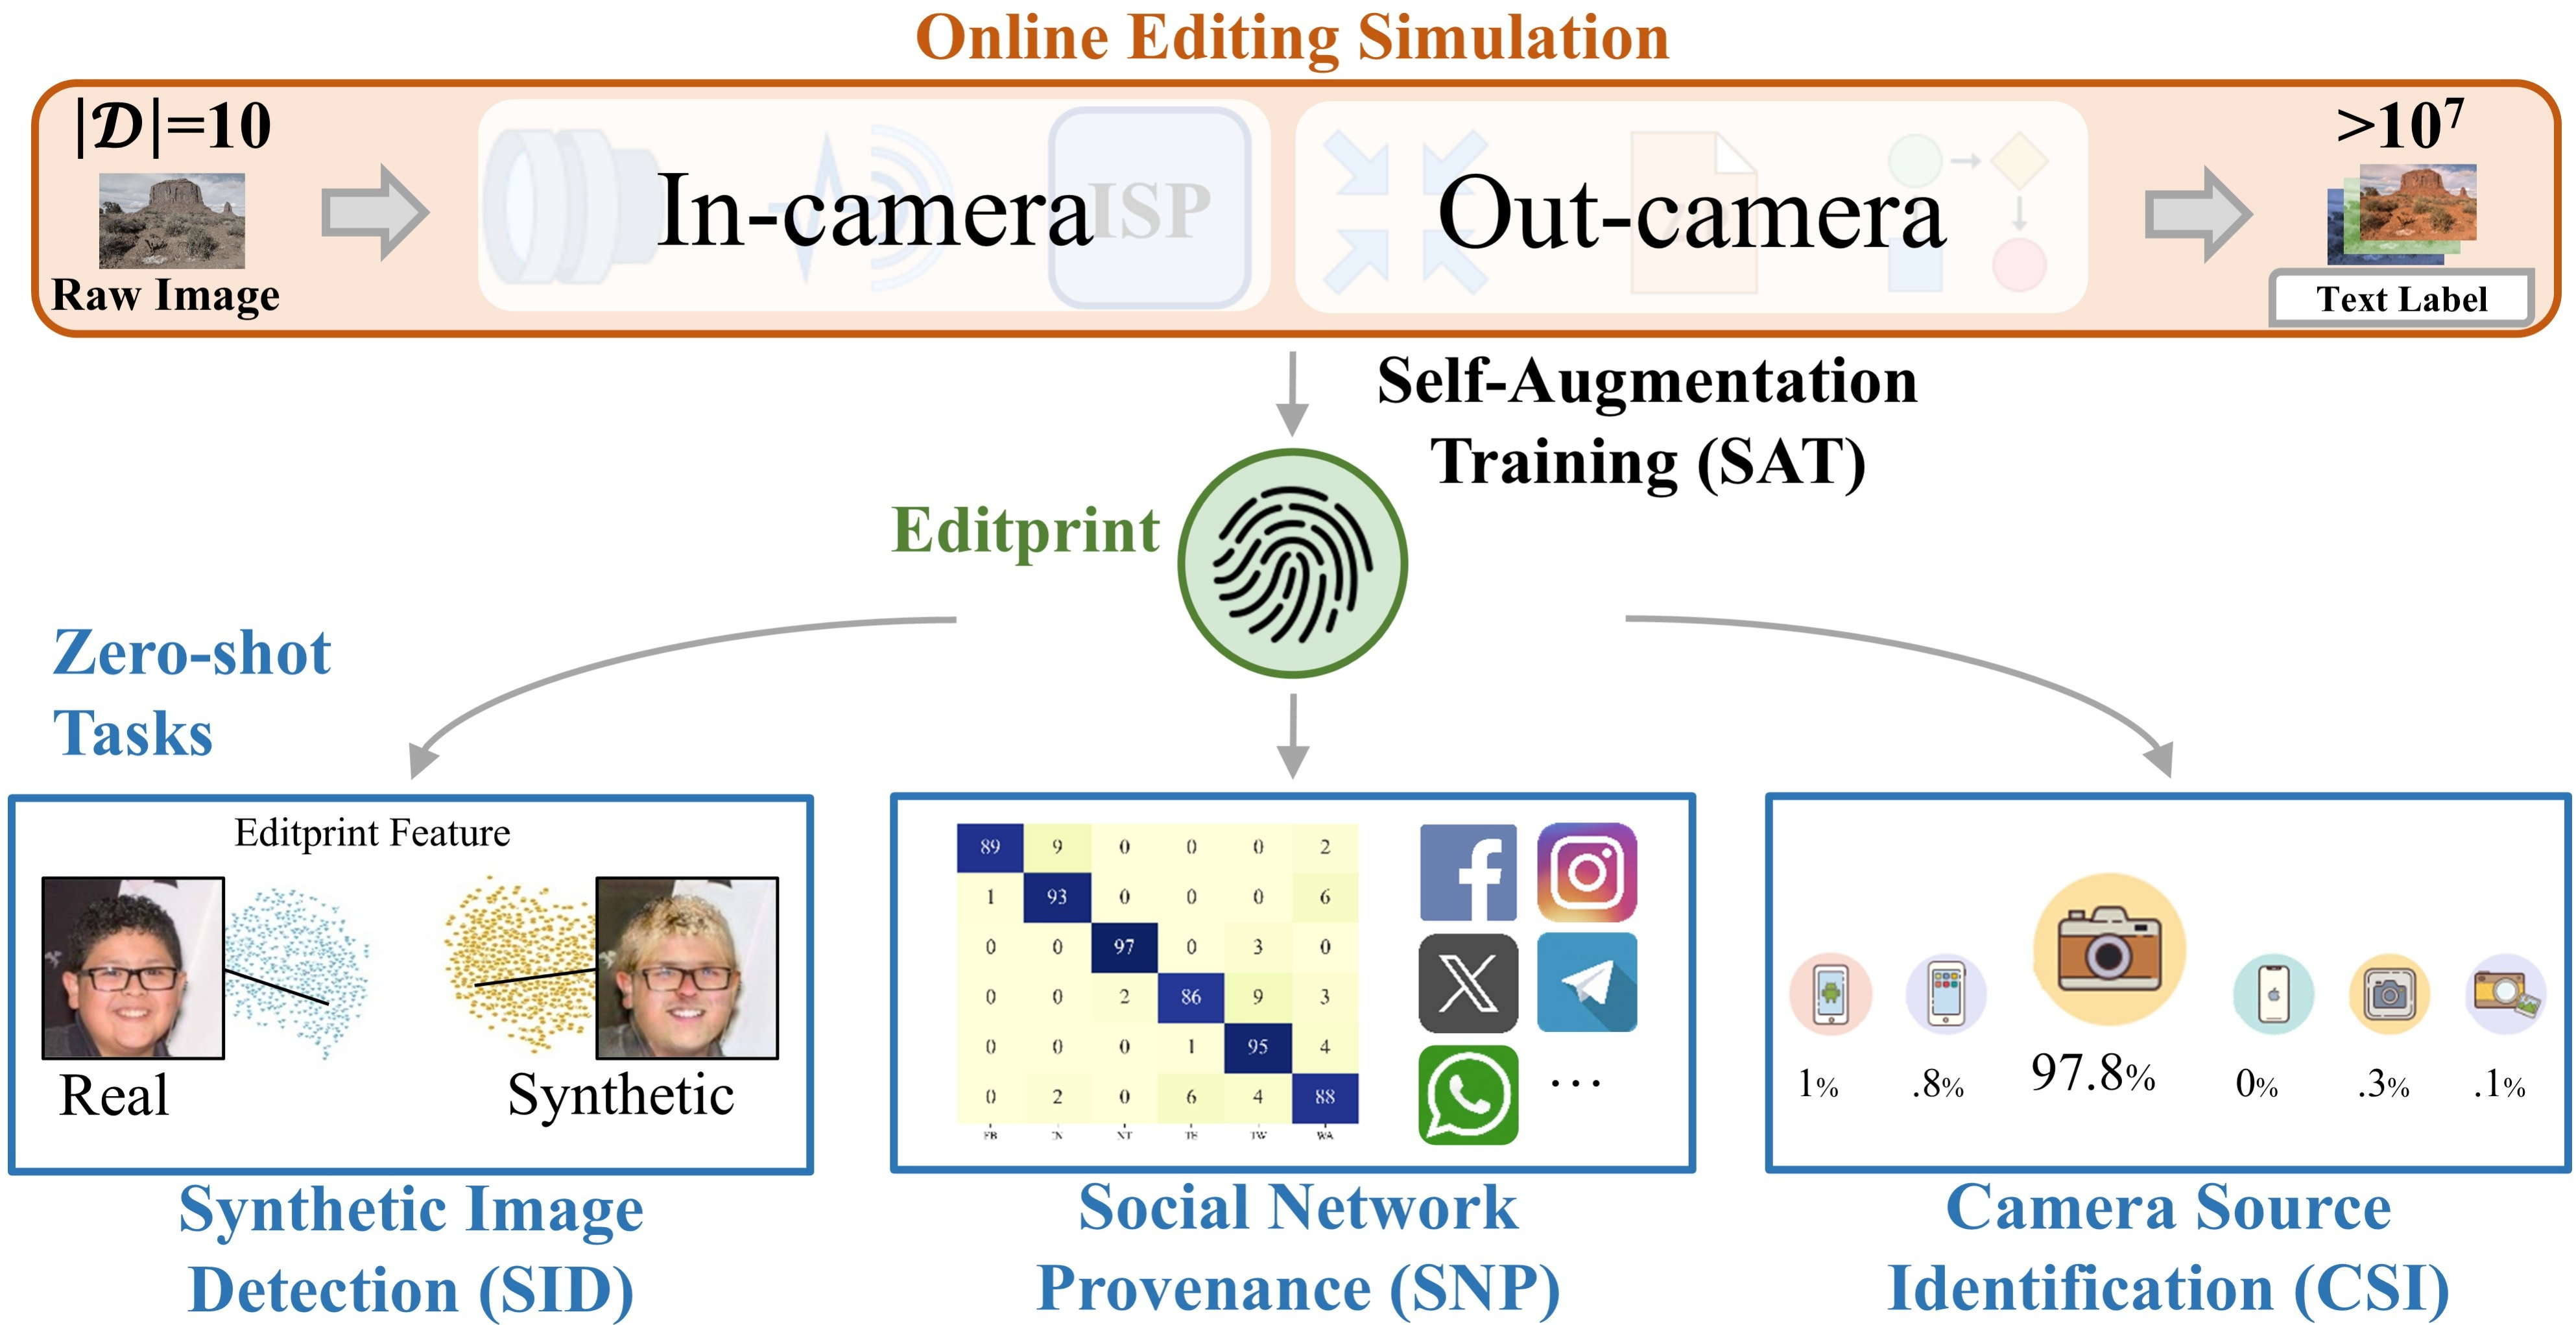
图1。通过采用自增强策略,Editprint仅使用10个样本即可有效学习超过条相机内及相机外轨迹数据,从而支持在零样本法医任务中实现泛化能力。
具体而言,我们首先定义了一套基础的相机内与相机外操作流程,包括去马赛克、色调映射和缩放处理。这些操作通过可变参数进行动态采样,形成编辑链,并应用于原始格式输入图像以生成包含多样化特征模式的大规模训练数据集。这种机制与依赖固定相机类型数据集的传统方法存在显著差异,同时实现了操作序列向文本标签的自动化转换。随后提出的SAT框架成为从上述技术生成的海量模拟数据中有效提取Editprint的关键工具,其由自构建分支和自适应迁移分支组成:前者通过高度可控的模拟流程显式构建模态内正样本对,侧重于全局对比学习;结合文本标签后,该分支能实现高效的多模态对比学习,显著提升Editprint的整体区分能力;后者采用领域适配分类器进行分类监督,最大化批次内编辑链间的分离度,从而特别增强了对具有细微操作差异的编辑链的识别性能。通过联合运用文本引导的对比学习与自适应分类监督,SAT能够在不同操作场景下实现既具备区分性又可迁移的特征表征。 综上所述,本研究的主要贡献如下:
- 我们提出基于从数字成像与传输过程中模拟生成的大规模自增强数据来构建监督式取证特征,这与现有依赖显式训练数据中的相机内痕迹或有限操作产生的相机外痕迹的方法形成鲜明对比;
- 我们开发了Editprint这一通用型自监督取证特征方法,仅需10张训练图像即可通过实时编辑池和语言引导的对比监督实现高效训练;
- Editprint可应用于多种零样本任务,大量对比实验表明其在非相机相关任务及相机相关任务中均优于现有最先进方法。
2.自监督取证领域的相关研究
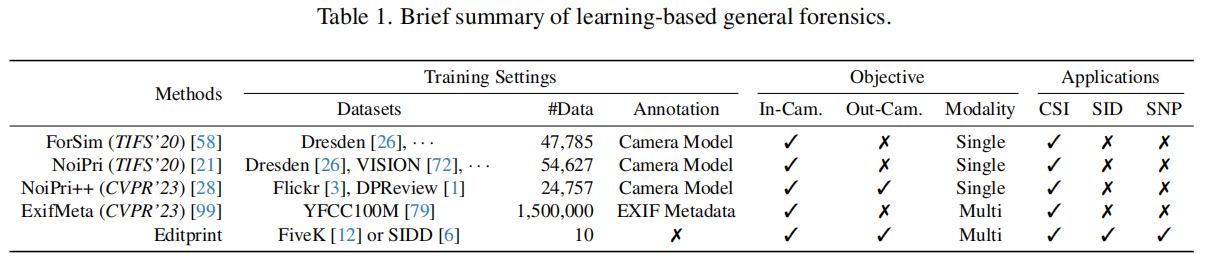
为探索无需依赖任何先验知识即可适用于多种取证任务的图像特征,本节主要综述自监督学习与通用取证方法[21,28,33,58,99]。 Cozzolino与Verdoliva[21,28]相继开发了NoiPri和NoiPri++算法,基于自监督对比学习技术,用于表征相机指纹及编辑历史(即图7所示的相机内/外操作)。他们证明,仅利用真实相机数据即可训练出能够识别图像真伪的取证模型。同样地,Mayer等人[58]开发了ForSim工具,用于判断两个给定图像块是否具有相同的特征,从而实现取证特征的获取。与仅依赖图像模态的前述法医分析方法不同,Zheng等人[99]采用图像的 EXIF 元数据作为文本模态,从而建立了图像与语言之间的跨模态对齐框架ExifMeta,以提取更稳健且通用的法医特征。尽管ExifMeta与我们的Editprint均采用基于语言引导的对比训练方式进行监督学习,但两者在两个关键方面存在显著差异: 1)与现有的通用图像取证技术[21,58]类似,ExifMeta以分析相机内部痕迹为研究重点;而Editprint则同时处理相机内部及外部痕迹; 2)ExifMeta需要大量标注元数据的训练数据(超过150万条),而我们的Editprint仅需极少量训练数据(低至10张图像)。 上述自监督图像取证方法的简要概述见表1。显然,这些竞争算法主要聚焦于相机内部痕迹分析,并针对相机相关任务进行评估。
3.方法论
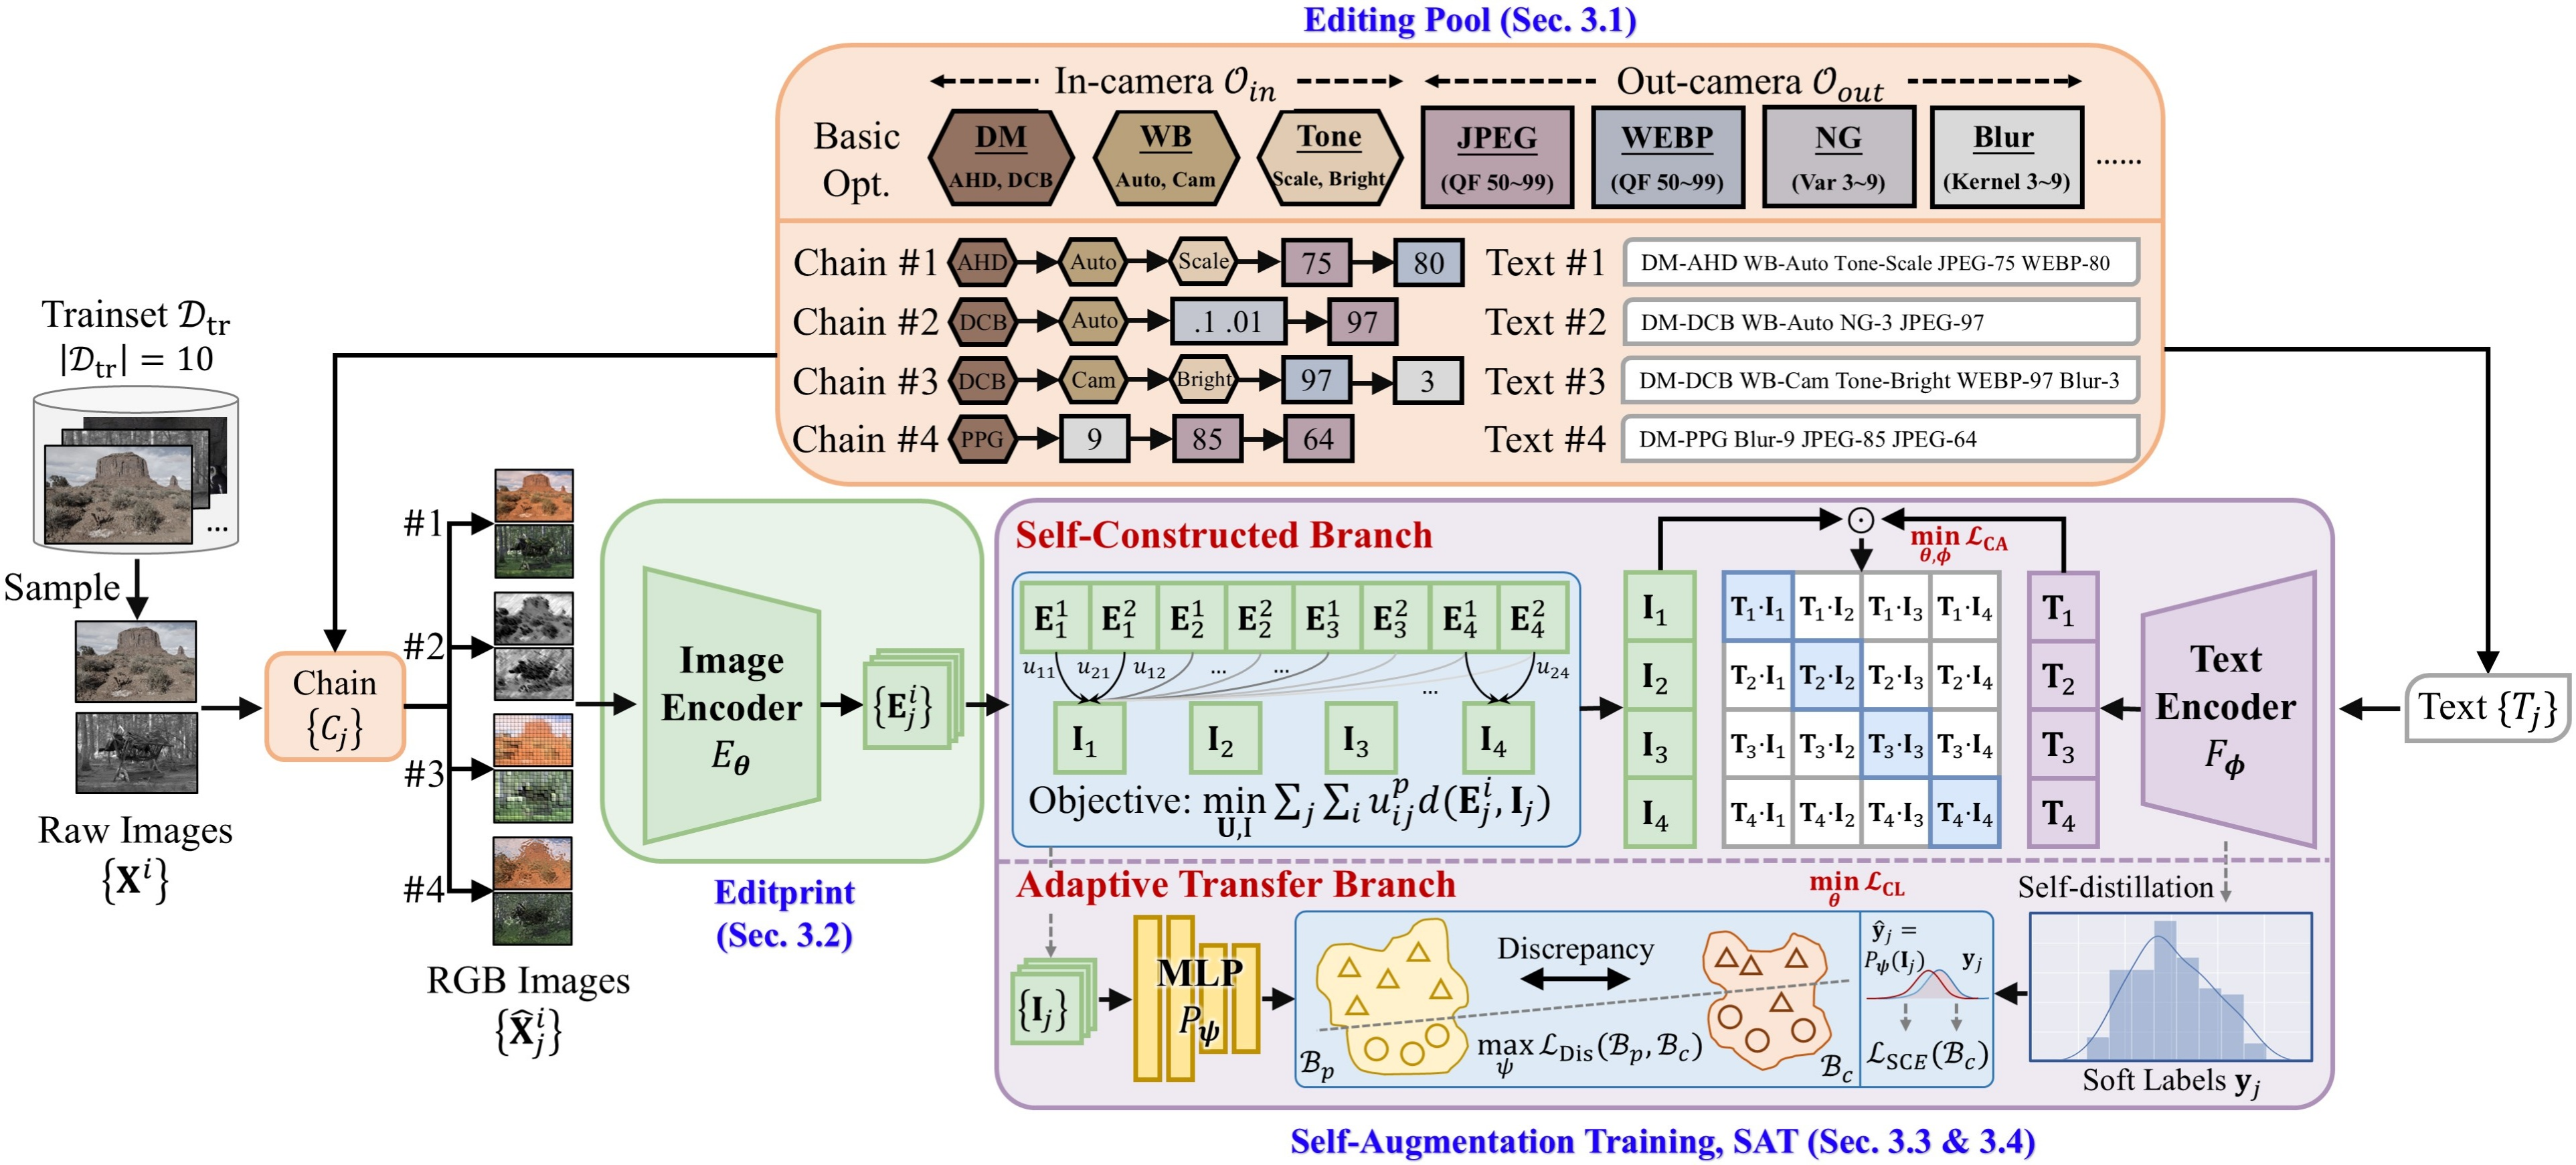
图2。所提出的Editprint训练框架主要由编辑池(第3.1节)、Editprint提取器(第3.2节)、带有自构建分支的SAT模块(第3.3节)以及自适应迁移分支(第3.4节)组成。该示意图以M=2张原始图像和N=4条链为例进行说明。训练完成后,仅提取器 Eθ 会在后续推理阶段使用。
图2展示了所提出方法的核心模块,即编辑池、Editprint的提取以及基于SAT范式的优化。具体而言,我们首先从训练数据集Dtr中抽取M张原始图像,并从编辑池P中抽取N组链式文本对,其中Cj和Tj分别表示第j条操作链及其对应的文本标签。随后将每条操作链Cj应用于所有M张原始图像,生成一批输入数据(其中 为经Cj处理后的Xi编辑版本)。接着,图像编码器(即Editprint提取器)Eθ 通过提取深度特征(Editprint)。为使Eij对不同操作轨迹具有高度区分能力,自构建分支结合文本编码器 Fϕ 提取Tj = Fϕ (Tj) ∈ RD,并利用对比损失函数对Eij与Tj进行对齐;同时,自适应迁移分支采用分类器 Pψ ,并基于操作链索引j最大化类别间距离。
3.1 编辑池
如图2顶部所示,编辑池P由多种编辑链组成,每条编辑链均配有一个自动生成的文本标签。根据定义,编辑链C是一组按顺序排列的编辑操作序列,可将原始图像X转换为RGB图像 Xˆ 。
其中 g(·)表示映射函数。现在我们将 O 定义为包含基本编辑操作的集合。具体而言,O 由两个子集组成:Oin 和 Oout,分别对应相机内部和相机外部的基本编辑操作;即 O = Oin ∪ Oout。
1)相机内部运算模拟了图像处理系统(ISP)将光信号转换为数字信号的过程,即把原始图像转化为RGB图像。为建模该ISP,可进一步定义Oin = ODM ∪ OW B ∪ OT E,其中包含去马赛克模块ODM、白平衡模块OWB以及色调映射模块OTE[50]。具体而言,相机内部编辑子流程可构建如下:
其中 , ,and 。控制参数 β1 ≡ 1 and β2,β3 ∈ {0,1}用于指示相应操作是否被激活。
2)相机外操作模拟了图像可能经历的后期处理步骤。相机外操作集Oout包含四种基本编辑操作:压缩、缩放、模糊和噪声添加。实验已证实,复杂的实际场景操作可通过对这些基本操作进行高阶采样来模拟[85]。因此,可通过随机采样Oout生成长度为m的相机外编辑子链Cout。
其中 Oi ∈ Oout,for 1 ≤ i ≤ m。
获取输入链(Cin)和输出链(Cout)后,我们可以将它们连接起来形成完整的编辑链 C = Cin → Cout。分别用集合 C、Cin 和 Cout 表示包含所有可能编辑链的集合。经计算可知 |Cin| = 48,|Oout| = 194,因此 。关于摄像机输入/输出操作的更多细节,请参见表5和附录B。 如前所述,每个元素 Cj ∈ C 都关联着一个自动生成的文本标签 Tj,无需人工干预。一种简单的解决方案是为每个编辑链单独标注唯一标签以形成独热标签,但这种方法不仅需要管理复杂的标签向量,还会导致所有编辑链之间存在相同的相似性。受CLIP[67]等最新多模态训练范式的启发,我们提出了一种从自然语言角度自动生成文本标签的自动化方法:文本标签的语义丰富性能够以较低复杂度捕捉隐含的结构相似性,从而缓解独热标签带来的问题。具体而言,对于每个 Cj,我们根据编辑操作的顺序定义 Tj,并最终构建编辑池 ;同时需注意,文本标签的具体格式并非强制要求——只要相同操作由同一文本表示即可。不同标注方式的进一步比较详见附录H。
3.2. Editprint提取器
设 Eθ 为用于提取Editprint的图像编码器,其中 θ 表示可训练参数。给定具有编辑痕迹类别j的输入图像 ,其Editprint可通过提取,该结果能够表征编辑痕迹特征。由于本研究的重点并非开发新的提取器,我们直接采用EfficientNet[78]作为 Eθ 的架构。该架构的选择基于对ResNet[31]、XceptionNet[20]、ViT[38]等不同候选架构编辑痕迹提取性能的初步比较实验;详细实验结果详见Appx.H部分。
3.3 自重构分支方法
将图像与其对应的文本标签在图像-文本联合特征空间中进行对齐,是一种有效的对比训练范式(例如CLIP[67])。该范式的总体目标是最大化匹配的图像与文本对之间的相似度,同时最小化不匹配的情况。给定编辑打印样本Ej自动生成的文本标签Tj,自建分支方法引入文本编码器 Fϕ 来提取文本特征Tj = Fϕ (Tj) ∈ RD。其中 Fϕ 是一个具有可训练参数 ϕ 的文本Transformer[66]。 在具体实现对比训练时,我们提出了两项区别于经典CLIP的方法:1)自建正样本对(SCPP);2)模糊映射(FM)。CLIP范式中的原始正样本对仅以图像-文本对形式存在,因为难以明确描述单一模态(尤其是图像模态)内的关联性。而本研究中,通过编辑池增强的训练图像具有高度可控性,能够显式构建正样本图像对——即使用同一编辑流程处理不同图像。因此,我们建议使用 SCPP 生成M个正样本对以加速训练过程。虽然创建额外正样本对较为直接,但其优化至关重要。从语言模态视角来看,文本标签原本仅对应一个正样本对,现在则对应M个正样本对。一种简单的解决方案是假设这些正向配对贡献相等,并采用其平均值替代。然而,这种方法明显忽视了与文本标签相关的不同图像所呈现的差异性置信度(例如,在相同编辑流程下,平坦纹理痕迹与丰富纹理痕迹之间的区别),以及不同编辑操作本身固有的模糊性[41,43](例如“DM-AHD JPEG-75”与“DM-AHD Blur-3”之间共享的中间特征)。因此,我们提出基于模糊理论[60]的FM变换方法,以明确建模各类别间的重叠关系。通过构建并优化隶属矩阵,FM能够从图像模态的角度出发,以加权方式生成新的特征。 具体而言,对于每个编辑链Cj, SCPP 策略首先生成M个正样本对。为确保一致性并降低对比学习中的链内变异性,我们进一步通过FM策略将这M个特征聚合为单一代表性图像特征。FM采用隶属矩阵 ,通过对进行加权求和来聚合特征,最终得到N个新的图像特征。每个权重uij表示Eij与Ij之间的关联程度,且满足约束条件,对于每一个,有。优化矩阵U的目标是最小化Eij与Ij之间的距离;因此,设I=[Ij ]j∈[N] ∈ R D×N ,则可建立以下约束优化问题以求解最优隶属矩阵:
其中, U·j is the j-th column vector of U,ρ ∈ [1,+∞) 为模糊系数[60](经验值设定为2), d(·,·)表示距离函数(如 ℓ2 距离或余弦距离)。为简化讨论,下文均采用 ℓ2 距离。为求解该约束问题,我们运用拉格朗日乘数法构建拉格朗日函数。
其中 λ = [ λi ]_{i∈[M]}表示拉格朗日乘子向量。最小化J函数即对应于求解L的驻点,这些驻点处L关于U、I和 λ 的梯度均为零。将L关于Ij的梯度以及L关于uij和 λi 的偏导数设为0即可得到解。
鉴于等式(6)中的uj和Ij相互依赖,我们采用交替迭代法持续更新U和I,直至目标函数J收敛。
在完成加权图像特征的构建后,我们为每个编辑链生成最终的正样本对 (Ij,Tj)。相比之下,负样本对则是通过将聚合后的特征 Ij 与批次内所有其他编辑链的文本特征(即 {(Ij,Tk)}_{k=j})进行配对而隐式生成的。随后,我们通过对这些正负样本对应用对比损失函数来实现视觉-文本对比监督:具体而言,沿第一维度定义的对比损失函数 LCA 表示为
其中 τ 为学习得到的温度参数。最终,对比监督方法的整体目标可表述为:
3.4 自适应迁移分支
尽管上述自构建的分支在学习判别性编辑模式方面通常效果显著,但在某些复杂场景(尤其是涉及相似编辑链类别时)可能表现不佳。这一问题源于类别区分能力约束不足,导致在学习到的特征空间中决策边界不够明确[8]。 因此,我们提出采用自适应迁移分支方法来提升不同类别特征与决策边界之间的区分度。一种有效的实现方案是利用分类器[44]最大化类别间的距离差异。考虑到在线编辑数据集产生的类别数量极为庞大,构建一个能覆盖所有类别的全局分类器并不现实。为此,我们将分类器的目标函数调整为仅评估当前数据批次中包含的类别。鉴于不同批次中的类别可能存在显著差异,我们采用了领域适应技术[16,34,51]来降低领域差异对分类器训练的影响。 具体而言,我们采用具有可训练参数 ψ 的多层感知机(MLP)Pψ 作为分类器[42]。给定当前图像与文本特征批次, Pψ 将Ij转换为预测概率 ,旨在显著提升不同特征类别间的区分度。为获取适用于 Pψ 训练的软标签,我们运用蒸馏技术[47,98]计算从文本模型 Fϕ 中学习到的文本特征的自距离;随后即可通过软交叉熵损失函数实现分类目标。
由于分类器的目标在于区分当前批次内的编辑类别,因此可能在不同批次间出现更新不稳定性。为确保分类器能有效指导当前批次的分类监督任务,我们引入自适应约束机制以惩罚前后批次间的特征差异。受 WGAN [9]启发,我们设计了K-Lipschitz判别函数f:该函数对先前特征I_p∈B_p∼D_p赋予较高评分,对当前特征I_c∈B_c∼D_c则赋予较低评分。随后可通过两个特征分布之间的1-Wasserstein距离来衡量批次间的差异。
其中 ∥ · ∥L 表示Lipschitz半范数[83],sup表示满足 ∥f∥L ≤ K的所有函数f上的上确界(最大值)。最小化W1(Dp,Dc)自然能降低批次间的差异,从而增强前后批次在类别层面的相关性。根据[16],我们可以采用在前一批数据 ∥Pψ(·)∥∗ 上训练的分类器输出结果的核范数作为评估函数f,即 Pψ (I p) = [ Pψ (I p)]I p∈Bp ∈ R N×N 。因此,等式(10)中的批次差异可表示为:
其中WN是WN(Dp,Dc)的缩写。随后,可通过最大化差异损失来估计 KWN 。
通过这种方式,Editprint提取器 Eθ 与分类器 Pψ 的联合训练可通过最小-最大优化实现。
将自适应差异约束等式(13)与软交叉熵损失等式(9)相结合,用于优化分类监督的总体损失可表示为:
总之,文本编码器 Fϕ 和分类器 Pψ 分别提供对比监督与分类监督功能,并与Editprint提取器 Eθ 以端到端的方式联合优化,以实现整体目标。
3.5. Editprint的使用
图3展示了经过充分训练的 Eθ 在开集验证和闭集分类中的应用,该方法遵循了先前的研究[21,56,58,90]。
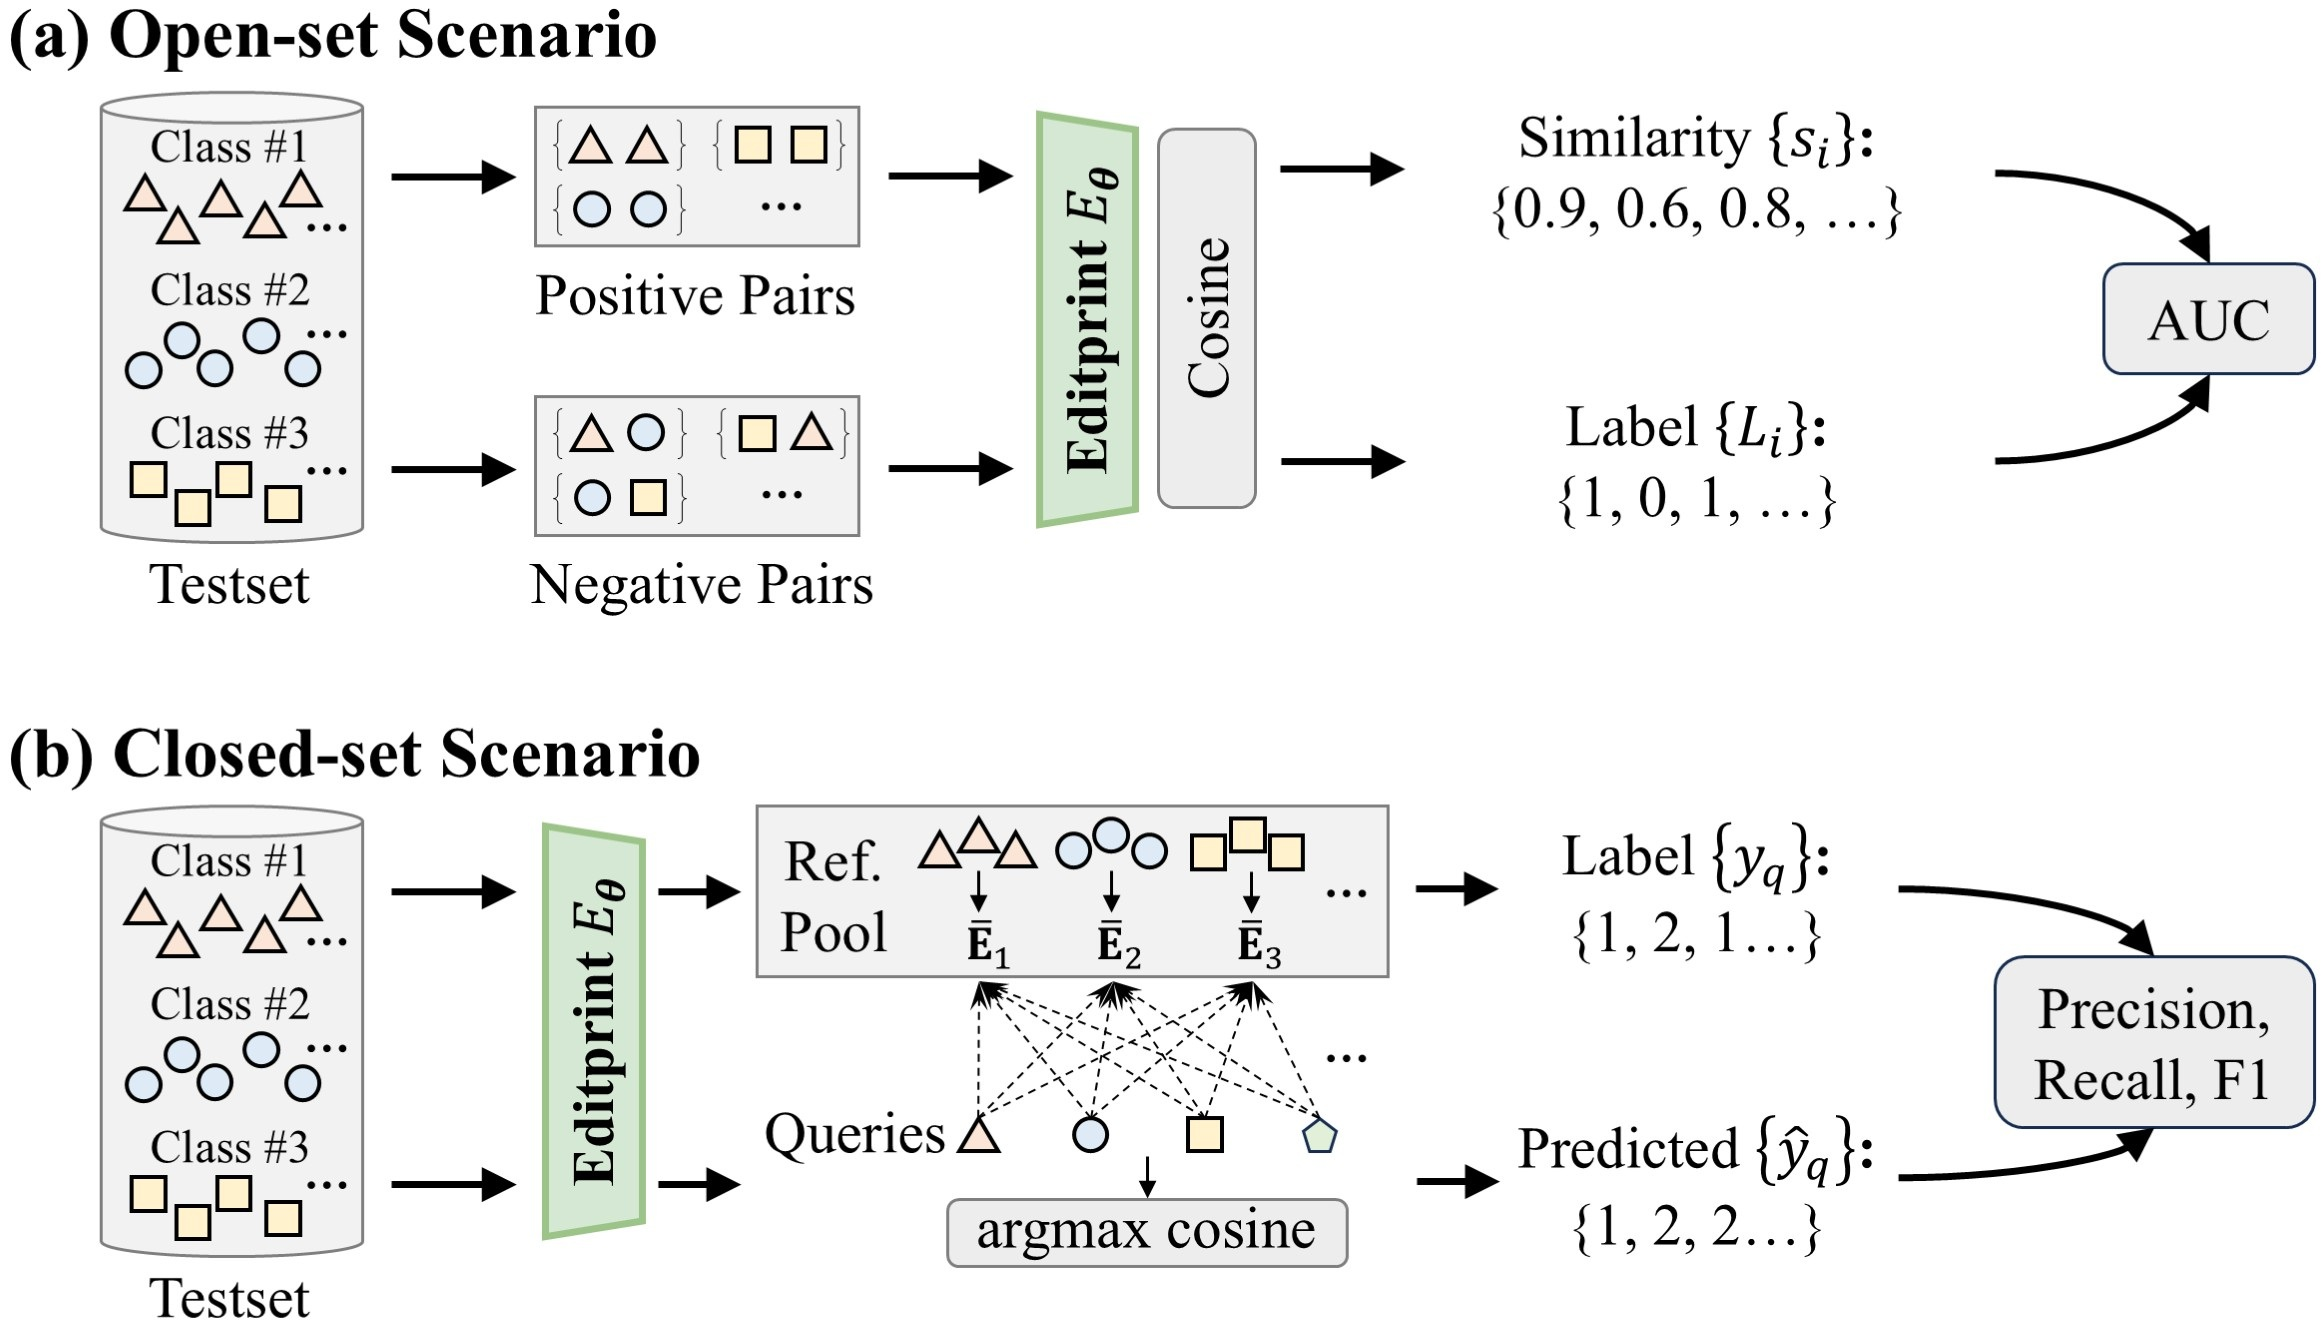
图3. Editprint在开放集与闭合集场景中的应用。
更多细节详见附录C。
4.实验部分
首先介绍实验设置,随后全面评估所提出的Editprint算法在多种应用场景中的性能表现(包括SID(第4.2节)、SNP(第4.3节)及CSI(第4.4节))。此外,还开展了系统的消融实验并进行了分析。由于篇幅限制,具体测试细节及其他结果均置于附录中。
4.1 训练数据设置
我们从FiveK[12]数据库中随机选取原始图像构成训练集Dtr。这些原始图像由佳能、尼康等相机以 DNG 格式拍摄,可使用RAWPy和 DCRAW 等工具轻松处理。考虑到训练过程中编辑池可显著扩充Dtr规模,我们发现|Dtr|=10已足以满足Editprint模型的训练需求。不同训练数据的影响详见附录H.5。
评估指标方面,遵循文献[56]惯例,我们采用广泛使用的AUC指标作为开放集验证的评价标准(正负样本数量Npos和Nneg均设为10,000);在闭集分类任务中,每个类别包含Nref=25个参考样本和Nquery=100个查询样本,并主要采用精确率(PRC)、召回率(RCL)和F1分数评估分类性能——所有指标均以较高数值为优。
竞争方法部分:为展示Editprint的优越性能,我们选取四种通用取证方法(ForSim[58]、NoiPri[21]、NoiPri++[28]及ExifMeta[99])作为对比对象,这些方法均具备表1所示的自监督取证特征建模特性;此外还引入了任务特定的监督学习方法以进一步比较取证性能,具体细节见附录E-G。
4.2. 任务SID
4.2.1. 开放集场景
4.2.2. 闭集场景
4.2.3. 特征可视化
4.2.4. 泛化性归因
4.3. SNP任务:开放集场景
表3列出了不同方法在开放集验证任务中的性能表现。可以看出,ForSim、NoiPri、NoiPri++和ExifMeta在区分各类在线社交网络(OSN)轨迹时均存在困难;特别是在包含10个社交网络的极具挑战性的 SDR 数据集中,NoiPri、NoiPri++和ExifMeta仅获得0.50的AUC值,接近随机猜测水平。相比之下,我们的Editprint方法在视觉数据集和 FODB 数据集上均实现了超过0.90的AUC值;即使在极其困难的 SDR 数据集上,Editprint也取得了0.8120的AUC值,比排名第二的ExifMeta高出13.28%。虽然Seq2Seq和MultiClue通过使用实际 OSN 数据训练,在这些数据集上均表现出优异的验证性能,但其相对于我们自监督Editprint方法的AUC优势平均仅为0.99%和1.33%。这表明我们的编辑池通过构建大规模操作链有效模拟了 OSN 处理流程,从而能够准确识别社交网络痕迹。
4.4. CSI任务:开放集场景
由于竞争对手[21,28,58,99]的训练过程均明确使用标注摄像头数据,因此在CSI任务的表4中被归类为监督学习而非自监督学习。实验结果表明,自监督Editprint方法在 FODB 和 SDR 测试集上均展现出卓越的判别能力,分别达到0.8937和0.9755的AUC值,与表4中的最高成绩相当。采用AUC指标比较CSI任务中开放集验证性能的表现。方法、数据集、平均视觉 FODB 、 SDR 、Daxing自监督Editprint分别为0.9395、0.8937、0.9755、0.8710、0.9199;监督式ForSim[58]为0.9391、0.8893、0.9471、0.8866、0.9155;NoiPri[21]为0.9631、0.8965、0.9395、0.8391、0.9096;NoiPri++[28]为0.8758、0.7948、0.8994、0.7336、0.8259;ExifMeta[99]为0.9547、0.9028、0.9560、0.8708、0.9211(其中0.9028和0.8866为竞争对手所得值)。总体而言,自监督Editprint在四个测试集上均取得0.9199的平均AUC值,与监督式方法ExifMeta的0.9211 AUC仅相差0.12%。
5.结论
本研究提出了一种名为Editprint的通用法医特征识别方法,其核心在于捕捉图像采集设备内外的联合特征轨迹。具体而言,通过构建庞大的在线编辑特征库,Editprint能够在极少量训练数据下学习多种图像编辑特征。此外,我们在算法设计中融入对比监督与分类监督机制,显著提升了模型的训练效果。大量跨场景实验表明,Editprint相较于现有主流法医分析方法展现出卓越性能。我们期待该方法能成为自监督法医分析领域的新基准,并为整个法医领域提供新的研究方向。