
ttt
Rethinking VLMs for Image Forgery Detection and Localization
Shaofeng Guo, Jiequan Cui*, Richang Hong
合肥工业大学大数据知识工程重点实验室(隶属于教育部)
摘要
随着人工智能生成内容(AIGC)的迅速发展,图像篡改变得日益普遍,这对图像伪造检测与定位(IFDL)任务提出了重大挑战。本文研究如何充分利用视觉语言模型(VLMs)来辅助 IFDL 任务。我们发现,VLMs提供的先验信息不仅难以提升检测和定位性能,甚至因其固有的语义合理性偏见而非真实性判断倾向而产生负面影响。此外,位置掩码明确编码了伪造特征概念,可作为VLMs的额外先验信息以优化训练过程,从而增强检测与定位结果的可解释性。基于这些发现,我们提出了一种新型 IFDL 流程—— IFDL - VLM 。为验证方法有效性,我们在9个主流基准数据集上开展实验,并评估模型在领域内泛化和跨数据集泛化的性能表现。实验结果表明,我们的方法在检测、定位及可解释性方面均持续取得业界领先水平。
代码可在以下网址获取:https://github.com/sha0fengGuo/IFDL-VLM
1.引言
安全性和鲁棒性长期以来一直是机器学习与计算机视觉领域的重要研究课题[4,15,30,31]。对抗鲁棒性[3,7,9,30,42,48]、分布外(OOD)泛化[6,15]、 OOD 检测[24,27,28,39,43]以及分布偏移[5,8,10,44]均旨在提升模型预测的可靠性。相比之下,数据安全则构成了另一项日益严峻的挑战[11,13,14,21,41,49]——恶意篡改或合成图像可能误导公众认知并扭曲历史记录。在人工智能生成内容(AIGC)时代,先进的图像编辑算法[12,16,32,37,38]已能生成高度逼真的内容或模拟真实事件场景,从而进一步加剧数据真实性与安全性方面的风险。
图像伪造检测与定位(IFDL)面临三大主要挑战: (I)如何协同利用高层次语义特征与低层次特征标记; (II)如何实现对不同类型伪造行为的泛化识别; (III)如何确保检测与定位结果的可解释性与可信度。 先前研究[11,29]引入了边缘检测正则化方法,引导模型关注边界不一致、光照差异等低层次特征线索;另一研究方向通过集成多个伪造检测专家模型[47]或收集涵盖多种篡改方式的大规模数据集[33,34]来提升泛化能力;近年来,视觉语言模型(VLMs)也被应用于增强模型的可解释性和可信度。本文重新探讨了VLMs的作用,并探索如何充分发挥其潜力以提升 IFDL 性能。
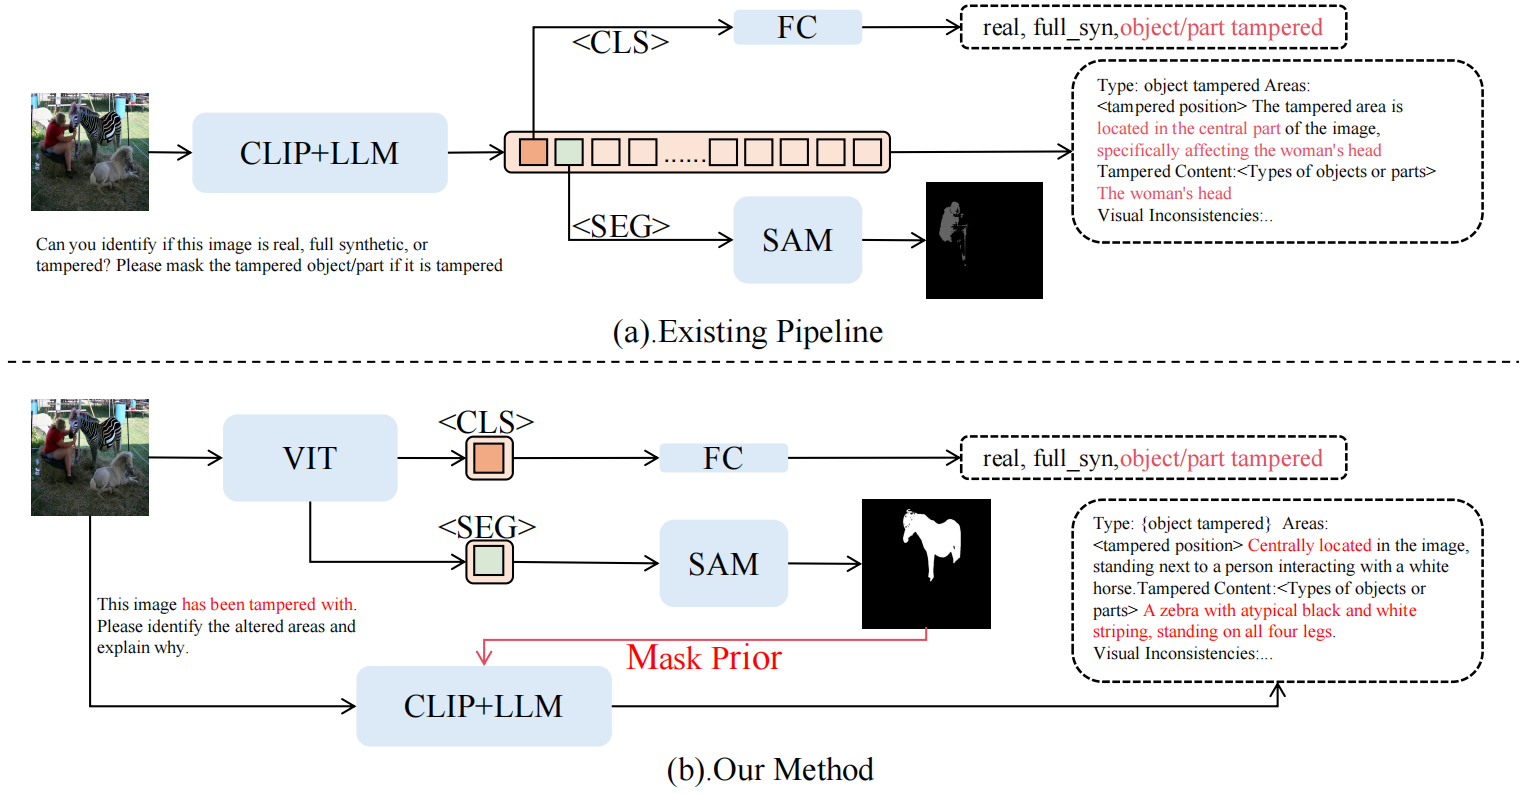
图1. 与现有 IFDL 流程的对比。(a)现有的 IFDL 算法通过来自大语言模型(VLM)的语言解释来增强可解释性;同时,用于定位和检测的/标记与/< CLS />标记均源自VLM的响应结果。(b)我们的 IFDL 方法将语言解释的优化与检测/定位任务解耦;此外,检测/定位结果被作为额外输入,辅助VLM进行语言解释的优化。
研究动机:如图1(a)所示,SIDA和FakeShield等早期研究将CLIP[35]、大语言模型(LLMs)[2]及SAM[20]整合到包含三个步骤的统一流程中: (1)将精心设计的文本提示与CLIP提取的图像特征输入LLM;(2)LLM生成用于检测与定位的自然语言解释;(3)LLM响应中的特殊标记< CLS\ >和<\SEG>触发线性分类器及SAM算法,从而输出伪造类型标签及突出伪造区域的掩码图像。
虽然来自CLIP模型的视觉-语言对齐先验知识以及来自大语言模型(LLM)的语言知识已被证实对图像描述和 VQA 等下游任务具有显著优势[25,50],但鉴于这些模型在大规模数据预训练过程中并未接触伪造相关概念,目前尚不清楚这些先验知识能否有效提升伪造检测与定位性能。此外,我们还从反向角度进行探讨:检测与定位结果能否用于优化大语言模型的训练过程,并进一步增强其可解释性?
我们的方法:为解答上述两个问题,我们提出了一种新的框架 IFDL - VLM(如图1(b)所示)。该框架包含两个训练阶段:
- 第一阶段:联合训练ViT编码器与SAM模型,实现伪造检测与定位。
- 第二阶段:将第一阶段获得的检测与定位结果作为额外输入用于 VLM 模型的微调。需注意,这些检测与定位结果明确界定了伪造概念;此后 VLM 模型无需再从数据中推断这些概念,从而简化优化流程并提升模型可解释性。
与先前研究[18,45]不同,我们的 IFDL - VLM 框架将检测与定位的优化过程与基于 VLM 的语言解释生成过程分离,并进一步利用推导出的定位掩码来促进 VLM 优化。实验表明,第一阶段生成的定位掩码可有效作为大语言模型(VLM)的辅助输入,从而提升检测与定位结果的可解释性;而来自VLM的先验信息对检测和定位性能贡献甚微。
实验结果:为验证该方法的有效性,我们在9个主流基准测试集上进行了评估,涵盖领域内及跨数据集泛化场景。我们的方法在检测、定位及可解释性方面均取得了新的前沿性能水平。
在定位任务中,我们的方法在SID-Set数据集上取得了0.65的IoU值,在8个数据集(CASIA1+、IMD2020、Columbia、NIST、DSO、Korus、DeepFake和AIGCEditing)上平均IoU值为0.47,分别比SIDA高出21%、比FakeShield高出13%。此外,在GPT-5可解释性自动化评估中,我们的方法获得总分2.44,较SIDA提升0.77分。 我们的贡献总结如下:
- 我们提出 IFDL - VLM 框架,用于研究如何充分利用大语言模型(VLM)解决 IFDL 任务;
- 通过 IFDL - VLM 方法发现,将定位掩码作为VLM的辅助输入可优化其训练过程,从而提升可解释性;同时, VLM 算法固有的语义合理性优先于真实性的倾向可能影响 IFDL 任务性能;
- 在9个主流数据集上进行了广泛实验,其中 IFDL - VLM 方法在检测、定位及可解释性方面均实现了新的前沿性能。
2.相关工作
AIGC 与 IFDL 挑战。 扩散模型[17,36]、生成对抗网络(GAN)[19]以及自回归变换器[40]能够实现逼真的图像合成,模糊了真实与虚假之间的界限。与传统篡改手法(如拼接、复制-移动)不同, AIGC 生成的伪造内容不会产生低级伪影,反而呈现微妙的语义不一致。混合型伪造——即结合了AI生成内容与传统编辑手段(如Photoshop处理)及后期处理技术(压缩、图像放大)——会进一步消除取证痕迹,使传统的 IFDL 方法失效。这要求我们为这类伪影稀少且语义合理的伪造内容开发新的数据集和检测方法。
图像伪造检测与定位(IFDL)。 IFDL 方法主要致力于法证痕迹建模——即检测并定位由图像处理引入的高层次语义错位及低层次不一致现象(如噪声、边缘伪影、压缩伪影)。现代框架通常将手工设计的先验知识(如 SRM DCT、BayarConv)与基于学习的组件相结合,以自适应地融合和增强法证特征信号;典型代表包括 MVSS -Net[11](BayarConv+多尺度边缘)、CATNet[21](DCT+RGB融合)以及DiffForensics[46](扩散预训练+边缘增强)。除痕迹建模外,另有两个研究方向受到关注:(I)领域泛化,旨在提升对未知篡改类型的抗干扰能力;(II)增强检测与定位结果的可解释性与可信度。
多模态大语言模型(MLLMs)。 诸如CLIP[35]等多模态模型通过跨模态预训练对视觉与文本表征进行对齐,实现视觉分析与语言分析与大语言模型的融合。这些创新在需要同时具备视觉理解与推理能力的领域(如内容生成、交互对话及多模态推理任务)产生了显著影响。借助大规模多模态数据集,MLLMs能够应对更复杂的挑战,例如图像描述[23,25]、 VQA [23,25]、图像分割[22]以及深度伪造检测。近期研究已证明多模态学习模型(MLLMs)在检测和定位图像伪造方面的强大能力[1,18,26,45],通过将图像分析与文本描述相结合,构建出更稳健的框架以识别细微篡改痕迹,并提升结果的可解释性。
3.方法—— IFDL-VLM
3.1. 视觉-语言对齐先验信息是否能提升 IFDL 性能?
CLIP和大语言模型(LLMs)在图像描述与 VQA 等下游任务中表现优异,这得益于其视觉-语言对齐能力和常识推理能力。然而,这些模型缺乏定位及低级特征线索(如边缘信息)的先验知识,而这些要素对图像伪造检测至关重要[11,21]。此外,由于大语言模型最初是为自然图像的全局语义对齐而预训练的,即便在 IFDL 数据集上进行微调,其固有偏差仍可能影响任务性能。
语义合理性与真实性之争。 当前主流的大语言模型(VLM)采用冻结的CLIP视觉特征作为输入,结合相应的语言标注对大语言模型进行微调。然而,CLIP模型的优化目标是使高层次视觉语义(物体或场景)与语言概念保持一致。因此,即使伪造图像中的某些物体或场景元素被替换、互换或篡改,其视觉特征表示仍能与原始文本标注高度吻合,导致伪造图像与真实图像难以区分,从而可能影响 IFDL 性能。
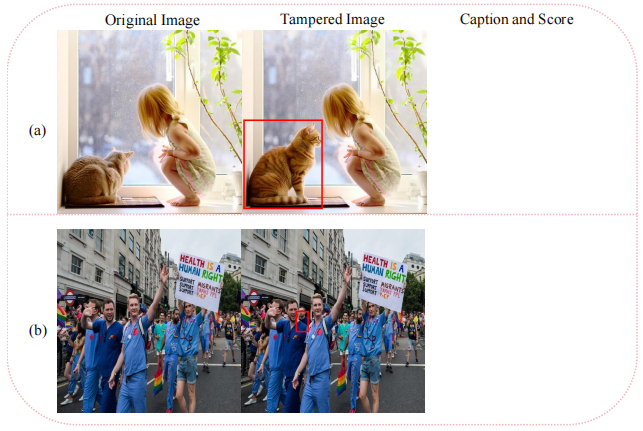
图2。VLM模型更倾向于追求语义合理性而非真实性。因此,它们往往对语义一致或细微的伪造内容(如(a)中的猫实例替换或(b)中的新增人物)缺乏识别能力。这种固有偏差最终会阻碍 IFDL 性能。
视觉语言模型(VLM)明显更重视语义合理性而非真实性,这使得它们容易忽略语义一致且细微的伪造行为。如图2所示:尽管图2(a)中猫的形象有所变化,图2(b)中新增了人物,但配文仍准确反映了图像的语义内涵,表明视觉语言对齐优化可能导致特征表示对图像真实性不敏感。定量分析显示,CLIP视觉特征的余弦相似度在猫图像与游行场景对中分别达到96.3%和98.5%,证实真实图像与伪造图像之间的特征表示难以区分。这表明VLM优先考虑场景的整体连贯性而非具体的视觉真实性,导致其在细粒度伪造检测方面效果欠佳。
3.2. IFDL - VLM
为解决第3.1节中的问题,我们提出了如图3所示的 IFDL - VLM 框架。该方法包含两个关键组成部分:(1)检测与定位以及语言解释生成的解耦优化;(2)利用检测与定位结果提升语言可解释性。具体实现细节如下: 检测与定位及语言解释生成的解耦优化。 我们并未在单一 VLM 中联合优化检测、定位和语言解释,而是将 IFDL 任务分为两个阶段: (i)采用集成SAM的可训练ViT骨干网络进行伪造检测与定位优化; (ii)通过大型语言模型(VLMs)实现基于区域感知的语言解释生成增强。
如第3.1节所述,视觉语言模型(VLM)缺乏对伪造相关概念的先验知识,其固有的语义合理性偏差甚至可能影响 IFDL 性能。为解决这一问题,我们提出采用专家级视觉Transformer(ViT)模型进行检测与定位。
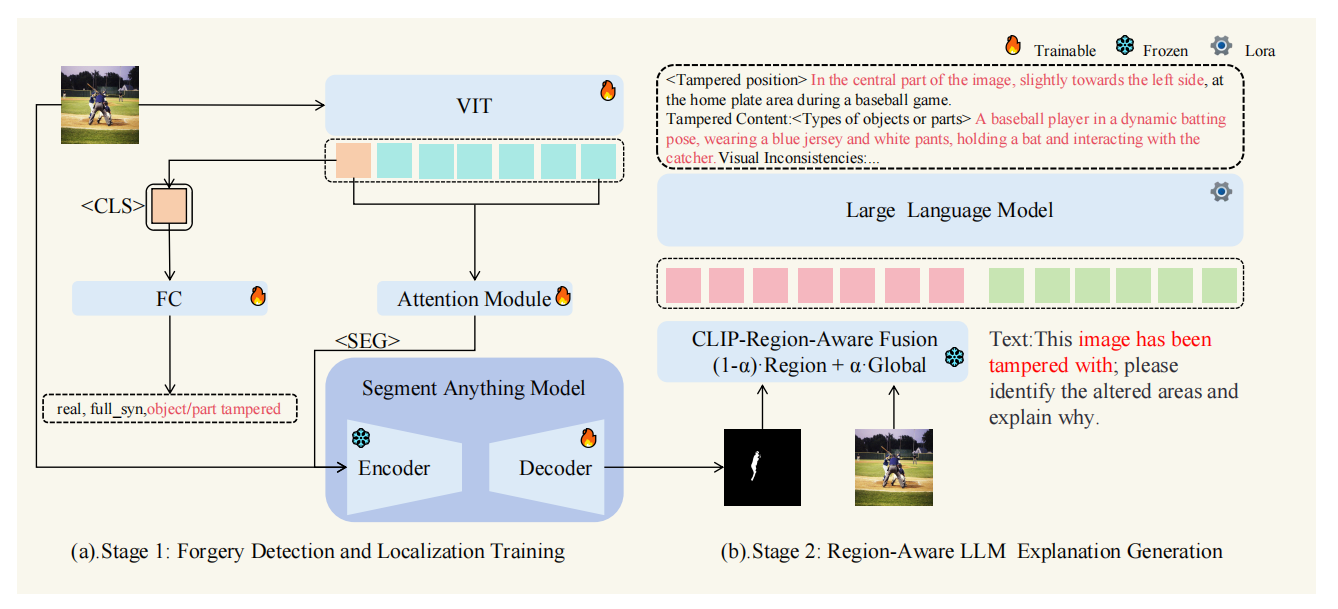
图3. 我们的 IFDL - VLM 框架。 IFDL - VLM 方法将检测与定位优化与语言解释生成过程解耦。(a)使用VIT和SAM进行检测与定位专家训练;(b)用于语言解释生成的区域感知视觉特征增强技术。
具体而言,如图3(a)所示,在第一阶段中,输入图像经可学习的ViT骨干网络处理后生成<SEG>和< CLS>两种标记:<SEG>标记输入SAM生成定位掩码,而< CLS >标记则用于线性分类任务。第一阶段的整体训练目标如下:
其中(λbce ,λdice ,λdet)表示超参数,默认值设为(1.0,1.0,1.0); Mˆ 和M分别代表预测定位掩码与真实定位掩码; Dˆ 和D分别表示预测伪造类型与真实伪造类型;Lbce表示二元交叉熵损失,而Ldice则代表骰子损失。
定位掩码编码了与伪造相关的概念 第3.1节中固有的语义合理性偏差也可能因真伪图像间视觉标记难以区分而对语言可解释性产生负面影响。为缓解此问题,我们提出引入第一阶段推导出的定位掩码以增强视觉特征。具体而言,如图3(b)所示,我们开发了区域感知视觉特征增强技术。总体而言,第二阶段的训练目标如下:
其中x为输入图像,Tvis为视觉标记, yˆdes 代表LLM的输出结果,ydes表示真实语言标注。除非另有说明,我们设定 α =0.5。推理时,我们将真实掩码M替换为第一阶段推导出的预测掩码 Mˆ 。 一方面,等式(2)通过在伪造区域引入低级线索来丰富视觉特征,从而提升真实图像与篡改图像表示之间的可区分性;另一方面,由于定位掩码明确编码了与伪造相关的概念,大型语言模型(LLM)无需仅从数据中学习这些概念,从而简化了其训练优化过程。因此,生成的语言解释质量得以提升。